采样、答案归一、多数票各管一段;票数多不等于答案对。
CoT 每次只生成一条解题过程,如果中间恰好算错,就可能把错误带到最后。Self-Consistency 的办法很好试:同一道题独立生成多份完整解答,选出现最多的答案。过程可以各不相同,统计只看最终结果。
先抽取、归一,再计数
看一组自拟结果。题目是 24 个苹果每盒装 4 个,问要几盒,模型五份输出如下。这里没有实际调用模型,表格只用来展示统计方法。
| 第几份 | 输出末尾 | 提取后的答案 |
|---|---|---|
| 1 | 需要六盒 | 6 |
| 2 | 24 ÷ 4 = 6,所以是 6 盒 | 6 |
| 3 | 需要 8 盒 | 8 |
| 4 | 答案:6 | 6 |
| 5 | 需要 4 盒 | 4 |
三份得到 6,选 6。如果直接拿整段文本当计数的键,第一、二、四份会分成三组,同一个答案也凑不到一起。所以实际实现先抽取、归一,再计数。上表第三列已经提取好了,下面的例子可以直接运行:
from collections import Counter
answers = [6, 6, 8, 6, 4]answer, votes = Counter(answers).most_common(1)[0]print(answer, votes)  # 6 3
抽取和归一的规则得自己定。数值题里,中文数字、单位、小数写法都可能影响归一:“六”和 6 算不算同一个答案,6 和 6.0 算不算同一个数,全看这一步。规则松一点,不同答案容易并成一票;紧一点,同一个答案会被拆成两票。选择题要把答案落到选项上。
论文自己的抽取也很朴素(§2 脚注 1、附录 A.2):提示把输出格式固定成“推理过程. The answer is X.”,算术题就取 “The answer is ” 后面的第一段数字,常识题取后面整串答案。作者明说解析器是任务相关的,换一类题就得换一个。
计数这一步也不是随便选。论文表 1 在 PaLM-540B、GSM8K 上比了六种聚合方式:
| 聚合方式 | GSM8K |
|---|---|
| 贪心解码(不聚合) | 56.5% |
| 加权平均(归一化) | 22.1% |
| 加权求和(未归一化) | 59.9% |
| 加权求和(归一化) | 74.1% |
| 多数票 | 74.4% |
同样 40 条样本,按归一化概率做加权平均,比只答一次还低 34 个点。多数票最简单,也最稳。
长篇文章没有这么清楚的答案集合,两段文字是不是同一个观点需要另外定义,这个计数程序搬不过去。论文 §2 也把这一条写成了局限:只适用于最终答案来自固定答案集的问题。
后来有两条路绕开它。Universal Self-Consistency 不抽答案,把几份回答一起交回模型,让它挑最一致的那份;代价是多一次调用,而且“一致”由模型自己判断。按它的表 1,8 条样本时在 GSM8K 上和标准投票打平(90.2% 对 90.4%)。语义熵那条线则是先按语义把答案聚类,再看分布有多分散;他们的实验(§4.2)里,答错的题答案在语义上更分散。
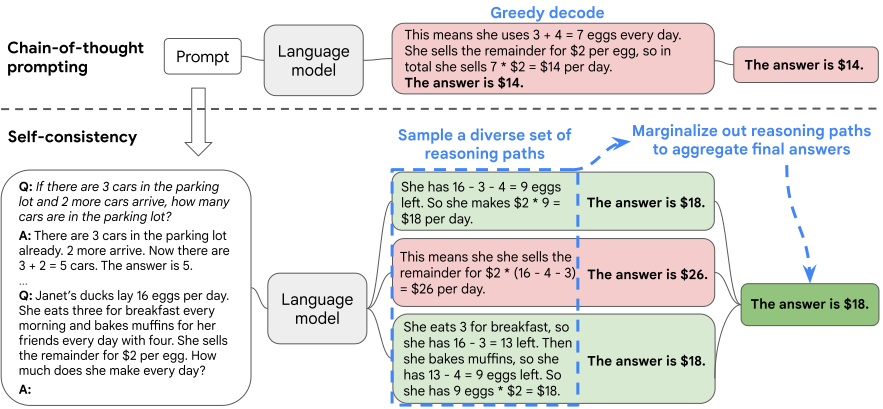
图源:论文 Figure 1,版权归原作者。它没有在中间步骤投票,也没有把几份过程拼成一份共同解法。
多条路径,其实是同一模型的多次采样
多份结果得真有差异。每次都贪心解码,通常只会反复拿到同一份内容;论文主实验用温度采样加 top-k(k=40,GPT-3 不截断),nucleus sampling 只在鲁棒性实验里试过。每次都从同一道题出发,不把上一份答案接进去续写。模型之间也没有讨论,所谓“多条路径”就是同一个模型生成了多次。
具体参数在 §3.1:PaLM-540B 用温度 0.7、top-k 40,UL2 和 LaMDA 用温度 0.5、top-k 40,GPT-3 用温度 0.7、不截断。
论文其实试过让不同模型一起投票(附录 A.1.3 表 10)。LaMDA-137B 加 PaLM-540B,GSM8K 只有 36.9%;三个模型一起上是 33.3%,都远低于 PaLM 自己投票的 74.4%。作者的解释是弱模型把强模型拖下来了。所以这里的收益来自一个强模型自己的采样分布,不是来自“多方意见”。
74.4% 是 40 条一轮、十轮平均
主实验每轮取 40 条,对 10 轮结果求平均。PaLM-540B 在 GSM8K 上:
| 设置 | GSM8K |
|---|---|
| 单条 CoT,贪心解码 | 56.5% |
| Self-Consistency | 74.4% |
提高 17.9 个百分点。56.5% 是单条贪心解码的基线,不在十轮平均里。作者比较过几种答案聚合方式,简单多数票已经表现不错;样本数增加通常还会改善,但收益越来越小。方法与实验 可以一起看。
这两个数来自论文,我没有复现。放进自己的程序时,调用次数也要一起算,不能拿四十份生成的费用去和一次调用比。
票数多,不等于答案对
回到苹果的例子,三票对两票选出 6。这回 6 恰好是正确答案,但计数程序只比较谁出现得多,不核对推导,换一道题就可能倒过来。
再自拟一个变体:题目改成“每盒最多 4 个,其中 8 个已经坏了,只装好的苹果”。实际只剩 16 个好苹果,需要 4 盒;如果模型反复忽略坏苹果,几份结果会一起给出 6。多次调用共享同一个模型的知识和理解习惯,次数再多也不保证它注意到漏掉的条件。
这个变体有实测的版本。GSM-IC 专门往数学题里塞无关信息,结果(§5.1、表 3)是 self-consistency 让所有提示方法都涨了分,但挡不住模型被干扰信息带偏。
更直接的是“自洽错误”研究:多次采样都收敛到同一个错答案,就叫 self-consistent error。他们发现(§3.2 表 1)这类错误不随模型变大而减少,靠一致性做错误检测的方法在它上面 AUROC 掉到 0.5 以下,还不如瞎猜。而且这种错误多半是模型特有的:Qwen2.5-14B 的自洽错误里,只有 9.6% 会让 Llama3.1-70B 也稳定犯同样的错。
还有一篇 2026 年的单作者预印本(arXiv 2608.11403)在 GPQA Diamond 这种难题上看到了反效果:采样多了,分布集中在某个错答案上,投票反而把错误锁死;Llama-3-8B 一致度最高的那一档只有 28.6% 是对的(§4.4 表 3)。
所以上表的 3/5 只能读作五份里有三份一致,不能说答案有 60% 的概率正确。五次采样各自从头写,但都出自同一个模型,算不上五个独立的信息来源;一致比例本身也没有经过正确概率的校准。置信度评测的一篇论文(表 3)里,GPT-4 只用一致性聚合时平均校准误差 ECE 是 12.0,把模型自报的置信度也并进来能降到 6.90。一致性能当个参考,当概率用还差得远。
如果现在要用,它就是几行代码的事。DSPy 的模块文档里,dspy.majority 做的就是对一组预测投票、返回最常见的回答。我会把力气花在两件事上:抽取和归一的规则写对,以及想清楚这道题有没有可能让模型每次都错在同一处。后者投票帮不上忙。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。