用原论文的百分比题对照 PS 提示,再看它主要减少了哪类错误。
20 个学生里,20% 学现代舞,剩下的人有 25% 学爵士舞,其他人学街舞。问街舞占全班多少?这道题几乎不用算,难的是“剩下的人”这四个字:现代舞 4 人,剩 16 人,爵士舞是 16 的四分之一,街舞 12 人,占全班 60%。
Plan-and-Solve(PS)论文的图里就用了这道题。我想弄清的是:“先列计划再算”到底帮了哪一步。
舞蹈题:计划之后答对了,但说不清是计划哪句起的作用
普通的逐步推理先写对了“剩下 80% 里的 25%”,下一步却把它换算成全班的 25%,得到 55%。每一步都像在认真算,人数关系却从中间就错了。换成先规划再计算,回答先列出要算哪些人数,再按剩余人数往下走,得到 60%。
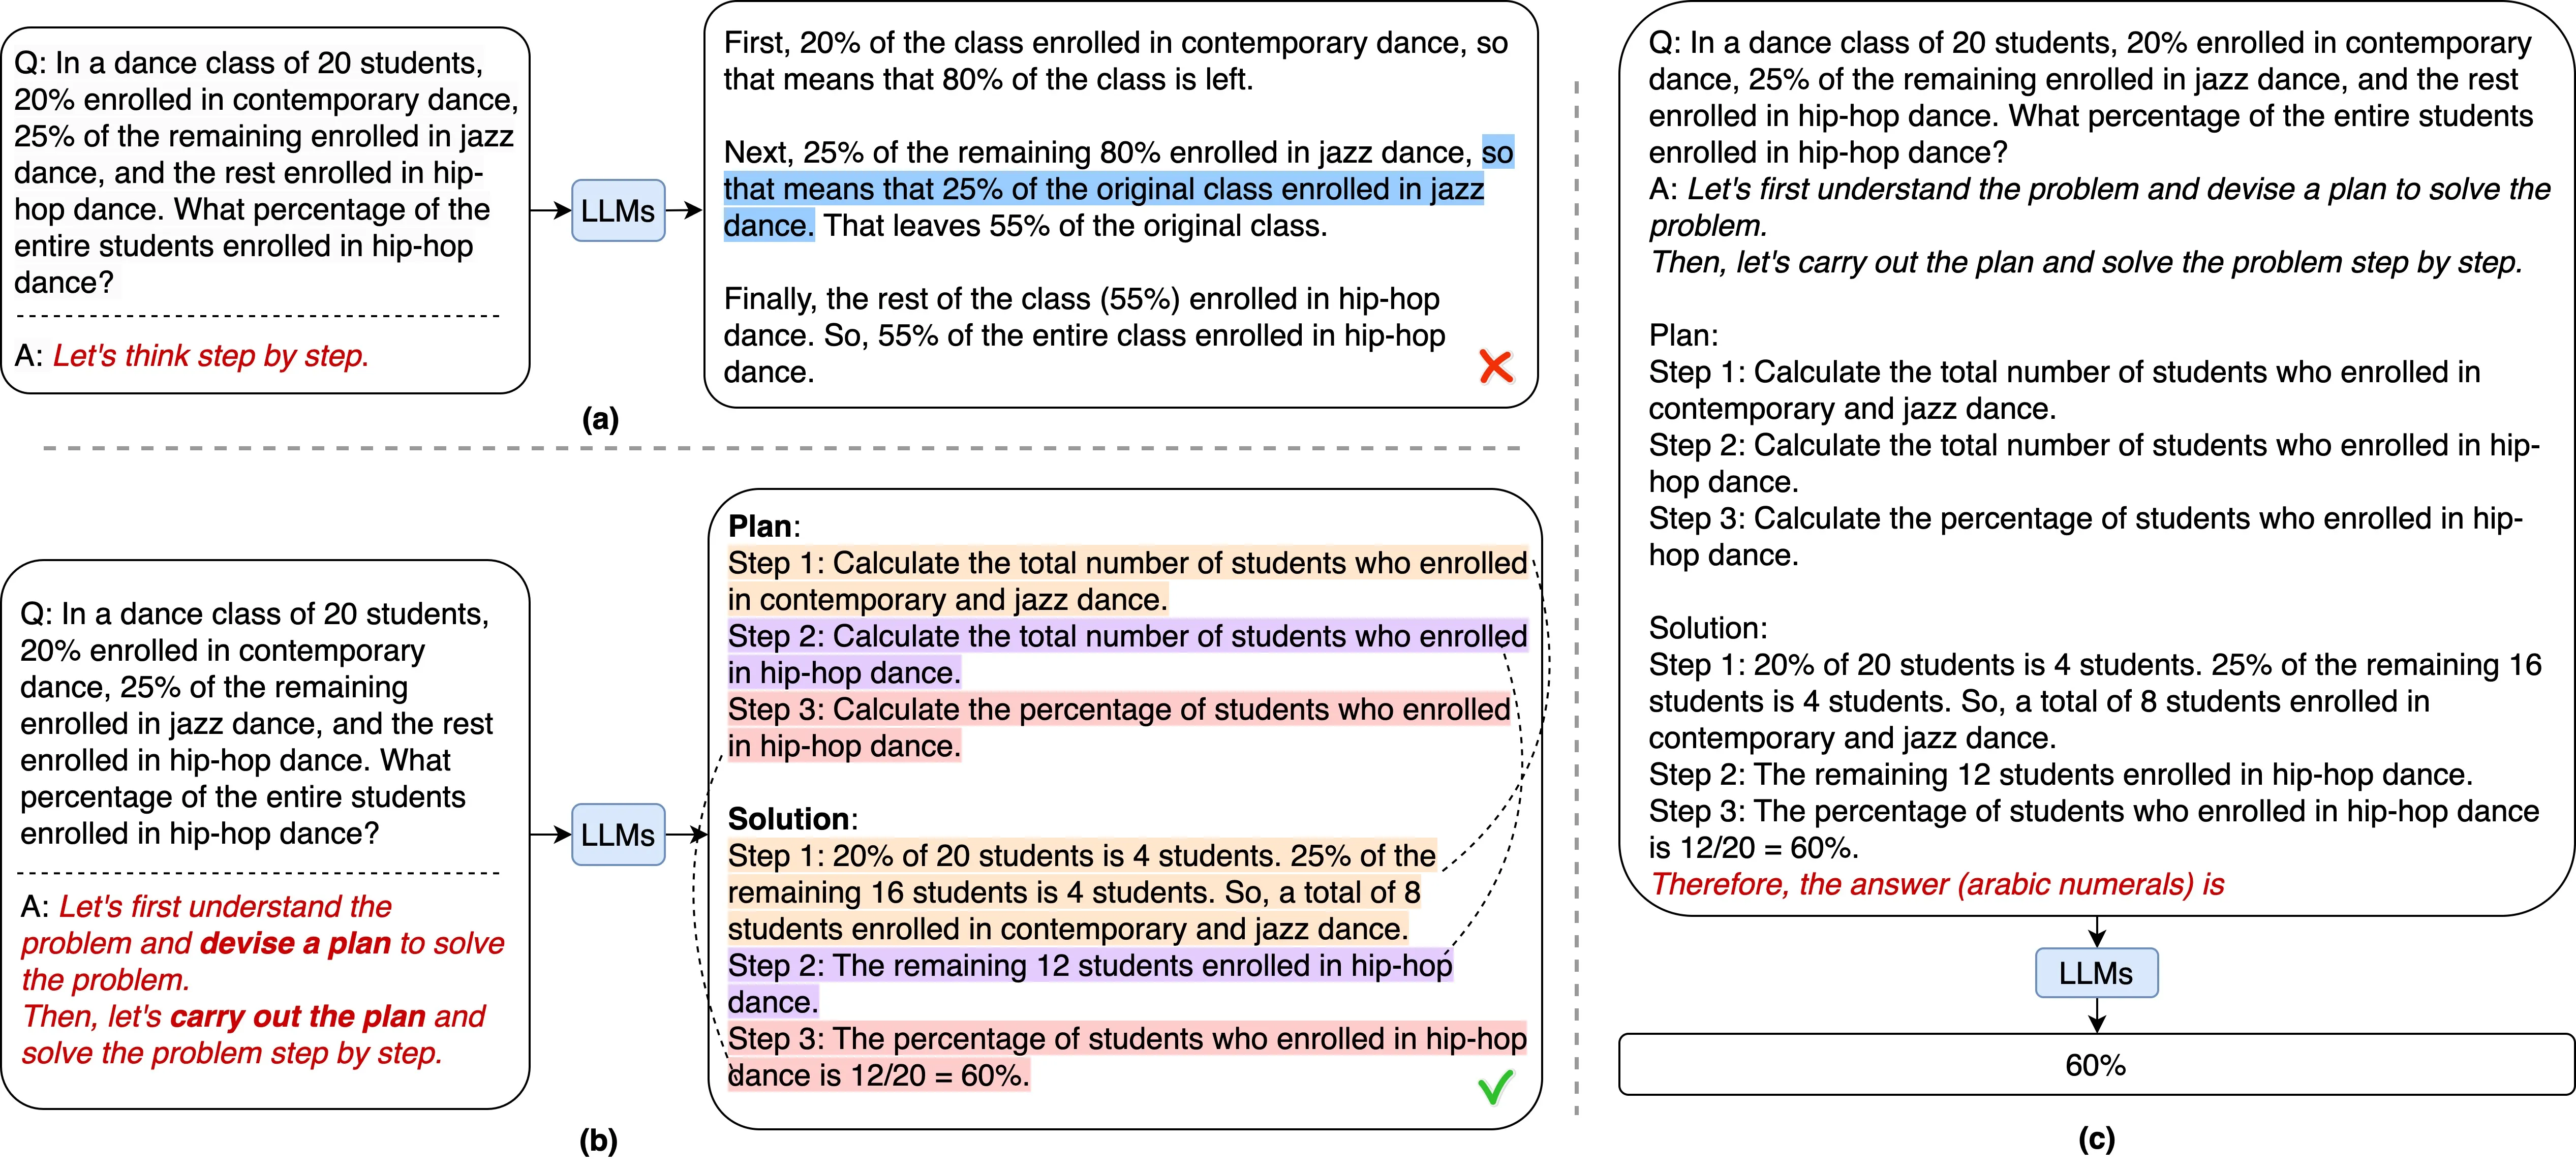
图源:原论文 Figure 2,版权归原作者。这是论文挑出来的例子,有多少题受益要看后面的总体实验。
细看这张图:Plan 只列了要算哪些人数,并没写“爵士舞的 25% 要乘剩下的 16 人”,这个关系是在后面的 Solution 里才写对的。所以这次回答确实改善了,但单凭这张图,说不清是计划里哪句话纠正了它。把“第一步分析、第二步计算”写得更长,比例取谁的问题并不会自己解决。
PS 和 PS+ 具体加了什么
- PS:在 Zero-shot-CoT 的基础上,要求模型先理解问题、分解并制定计划,再执行。
- PS+:进一步要求抽取变量和数值,并检查计算。
- 答案抽取:得到计划和解答后,再把它们送回模型,让它按格式输出最终答案,方便评分。图右边的 60% 就是这一步的输出。
第二次调用没有给参考答案,也不是独立验算,所以别把它当成“先答一次、再检查一次”。具体提示词在作者仓库里。想试的话,把同一道题分别交给几个版本,看计划里有没有写出题目里的数量关系,而不是看输出长了多少。
漏步少了,读错题没变
论文用的是温度为 0 的 text-davinci-003,每一步取概率最高的 token。正确率如下:
| 方法 | 六个数学数据集平均 | GSM8K |
|---|---|---|
| Zero-shot-CoT | 70.4% | 56.4% |
| PS | 72.9% | 58.2% |
| PS+ | 76.7% | 59.3% |
PS+ 相对 Zero-shot-CoT,六集平均高 6.3 个百分点,GSM8K 上只高 2.9 个。六集平均不能当成某个数据集上的预期。
同一张表(论文 §4.1 表 2)里还有一行容易被略过:让模型写 Python 求解的 PoT,六集平均 73.5%、GSM8K 57.0%,比 PS 还高一点,只输给 PS+。也就是说,“先计划”这个动作本身带来的提升,和换一种输出形式差不多大。
上面都是温度 0、每题只答一次。论文 §4.2 也试了温度 0.7 采样 10 次再投票(self-consistency):PS+ 在 GSM8K 上到 73.7%,Zero-shot-CoT 到 70.7%。两种方法都涨了十几个点,差距还是 3 个点上下。顺带一提,这一节写的 PS+ 不投票成绩是 58.7%,和表 2 的 59.3% 对不上,论文没解释。
总表说明有改善,但我觉得更有用的是 100 道 GSM8K 的错误分析:
| 错误类别(题数) | Zero-shot-CoT | PS+ |
|---|---|---|
| 漏了必要步骤 | 12 | 7 |
| 计算错误 | 7 | 5 |
| 语义理解错误 | 27 | 27 |
这 100 道是随机抽的,三类错误的题数就是百分比;答错总数 Zero-shot-CoT 46 道,PS 43 道,PS+ 39 道(§4.2 错误分析)。PS+ 减少的是漏步,读错题的数量一道没少。如果计划一开始就把爵士舞的比例理解成全班,后面照着计划认真执行,照样错。
还有一个容易被误读的数字。作者单独测了一条先抽取变量、再逐步求解的提示,GSM8K 只有 50.5%,比基线还低,论文的解释是它缺了制定和执行计划的指令,表格里留着这个结果。它是单独跑出来的,不能拿 PS+ 的 59.3% 去减,把差额算成这句提示的贡献。PS+ 整体有效,不代表拆出来的每句要求都有用。
同一张消融表(表 5)里,从 50.5% 到 PS+ 的 59.3%,差的不只是措辞:PS+ 多了制定计划、计算中间量等要求,50.5% 那条恰好缺了规划指令。作者在 §7 局限里也承认,GPT-3 对提示的表达很敏感。换一句话就是一版新提示,结果要重新测。
论文自己也只数了“有没有计划”
我在舞蹈题上说不清计划起了什么作用,翻回论文,作者其实也没回答这个问题。§4.2 里他们随机抽了 100 条 PS 输出,检查的是计划有没有出现:90 条里有。再往下做的相关性分析,说的是“有没有变量定义、计划、解答”和计算错误、漏步错误负相关。计划写得对不对,没人数过。
附录里这道舞蹈题还有一份 PS+ 的输出(附录 A.2 表 18)。它多了一段 Given:,写的是“Percentage of students enrolled in jazz dance = 25%”,基数照样没写;Plan 列了 5 步,到 Calculation 里才出现“25% of 16”。指令多了一条,抽出来的变量照旧没带上“剩下的人”。
这和作者在 §7 写的局限对得上:语义理解错误还在。我的判断是,PS 管的是“别漏步”,管不到“读对题”。后者要靠外部的东西去查,比如把抽出来的变量和题目原文逐个对照。
后来的工作把这个怀疑说得更重。LLM-Modulo 论文(§2.1–§2.3)报告,GPT-4 生成的计划里只有约 12% 真能执行,作者的结论是自回归模型自己做不了规划,也做不了自我验证。Huang 等人也发现,没有外部反馈时模型很难纠正自己的推理,有时越改越差。所以 PS+ 那句“检查计算”,我不会指望它真能查出错。
和 LangChain 的 Plan-and-Execute 不是一回事
这两个名字常被混着说。论文的 Plan-and-Solve 是一段提示词:一次调用里先写计划再解题,第二次调用只抽答案。这个两步结构也不是 PS 发明的,Zero-shot-CoT 原论文(§2)就是先用 “Let’s think step by step” 生成推理,再接 “Therefore, the answer (arabic numerals) is” 抽答案,作者自己说代价是要多调用一次模型。
LangChain 的 Plan-and-Execute 是一种 agent 架构:planner 是 LLM 加输出解析器,executor 是带工具的 Action Agent。博客里说灵感来自 Plan-and-Solve,也坦白了两个代价:计划只在开头做一次,之后不再回看;调用次数多了很多。名字像,一个是提示模板,一个是工程架构,讨论效果时得先分清说的是哪个。
怎么看一份 PS 输出
在计划和解答里找同一个量,看它的含义前后是否一致。舞蹈题就盯爵士舞人数:计划安排了这一步,解答里又是拿谁乘 25%。这样才分得清,它只是没漏步骤,还是连数量关系也处理对了。只看最后一行的 60%,看不出来。
连写出来的推理本身也不能全信。Anthropic 的忠实性研究发现,Claude 3.7 Sonnet 只有 25% 的时候会在推理里承认用了塞给它的提示,DeepSeek R1 是 39%,模型还会为已经选定的答案编理由。所以输出里写了计划,也说明不了模型真照着计划算。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。