从带步骤的示例开始,看收益在哪、在哪失效,论文里也有答案对、解释写反的题。
CoT 论文 的附录里有一道答案对、过程错的题:5 个苹果派,每个切 8 块,最后剩 14 块,问客人吃了多少。模型算出 40,再减 14,答案 26 没错;解释却把“剩下 14 块”写成“客人吃了 14 块”,又说剩下 26 块。
只看数字,这题通过了;把文字读一遍,才发现吃掉和剩下颠倒了。我觉得这个例子很适合放在 CoT 的介绍里:中间过程我们确实需要,但看见了过程也不能就放心。
示例里要写出解法,而不是只给答案
论文的做法是在提示词里放少量已经做完的题,每道都带问题、解题步骤和答案,再给新题,让模型照这个形式往下写。不更新模型参数,也不用先训练。后来常说的 Let's think step by step. 是 Zero-shot-CoT 的做法,和这里给完整样例不是一回事。
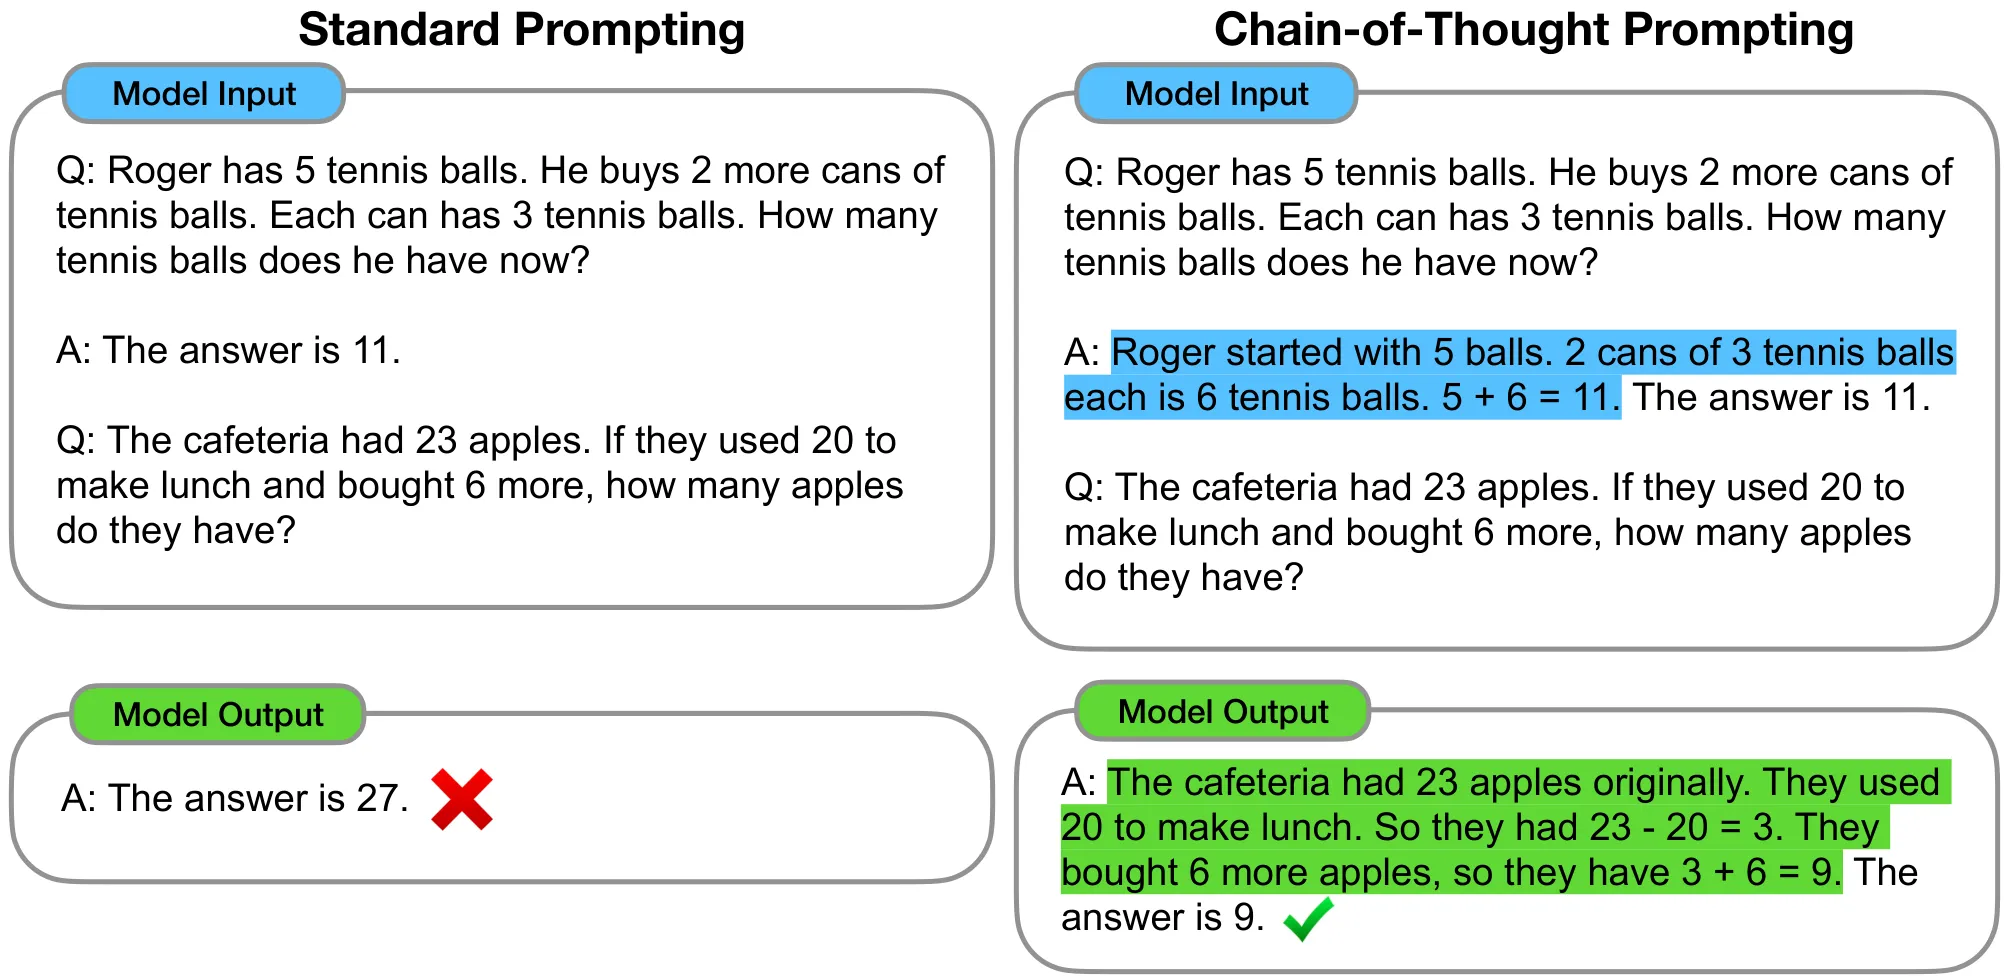
图源:论文 Figure 1,版权归原作者。左右两边的差别在示例答案里,右边把中间计算也写进去了。
自己写提示时,可以先挑一类容易检查的题。下面是自拟的示例:
问题:有 80 元,买三本每本 15 元的笔记本,再买一支 8 元的笔,还剩多少?解答:三本笔记本共 3 × 15 = 45 元。加上笔,一共花了 45 + 8 = 53 元。剩下 80 − 53 = 27 元。答案:27 元。论文自己的示例长这样(附录 G 表 20):Q: 后面是题,A: 后面一步步算,最后固定一句 “The answer is 6.”。答案单独收在一个标志词后面,程序好提取。附录 H 还交代,写示例的标注者就是论文作者,他们清楚 CoT 想要什么样的过程。所以这些示例是照着目标写的,谈不上中立。
示例只给 27,模型就得直接跳到结果;有了过程,生成“剩下多少”时,上下文里已经有 53 这个中间数。题目再复杂些,几步关系也能分开写清。样例本身也得检查完整,前面的题漏了一笔费用,就别指望模型从中学到正确算法。
中间量要写在答案之前
为什么不先答 27 再解释?文本是依次生成的,答案写出来时还看不到后面的解释。把 45、53 写在答案之前,算到最后一步时它们已经在上下文里;顺序反过来,答案先落定,后面的解释补不回来。
论文做了几组消融,都没有完整复现 CoT 的收益:
- 把答案放在推理之前;
- 只提供方程;
- 加入无实际内容的 token 来延后答案。
消融部分 值得一起看。表 6 用的是 LaMDA-137B,GSM8K 上的数字:
| 提示方式 | GSM8K |
|---|---|
| 普通提示 | 6.5% |
| 只给方程 | 5.4% |
| 只加无意义的 token | 6.4% |
| 先答后推 | 6.1% |
| CoT | 14.3% |
三种变体都贴着基线,只有完整的推理过程翻了一倍多。可见单纯把输出拉长,和给出有用的步骤,效果不一样。
56.9% 要连着模型规模一起读
数学实验通常放八个手写样例,AQuA 放四个,用贪心解码,也就是每步取当前概率最高的 token,不保证整条路径最优。GSM8K 上 PaLM-540B 的结果:
| 提示方式 | GSM8K |
|---|---|
| 普通提示 | 17.9% |
| CoT | 56.9% |
同一张表 1 里,其他模型的变化也不小:GPT-3 175B 从 15.6% 到 46.9%,Codex 从 19.7% 到 63.1%;而 UL2 20B 只从 4.1% 到 4.4%。表里当时最好的成绩是微调过的 GPT-3 加验证器,55%。PaLM 只靠八条示例就超过了它,这才是论文当年最抢眼的地方。
差距确实很大。两个数来自同一个模型、同一个数据集,区别只在示例里有没有写中间步骤,而且都是在论文那套样例和解码设置下测出来的。
另一面是,小模型可能写出不合逻辑的步骤,单步问题的改善也不明显,甚至有负收益。表 2 把这个负收益写得很具体:
| 模型 | 普通提示 | CoT |
|---|---|---|
| LaMDA 420M | 2.6% | 0.4% |
| GPT-3 1.3B | 2.4% | 0.5% |
| PaLM 8B | 4.9% | 4.1% |
| PaLM 62B | 9.6% | 29.9% |
小模型加了 CoT 反而更差,到 PaLM 62B 才明显转正。论文把这叫作随规模涌现的能力,说收益只在约 100B 参数的模型上出现。
这条线后来也有人质疑。Are Emergent Abilities a Mirage? 的一般论证是:看起来陡峭的“涌现”,很多是精确匹配这类不连续指标画出来的,换成连续指标就是平滑上升。这篇没有点名 CoT,但 GSM8K 恰好是按最终答案对错算分的,读图 4 那条阈值时我会留个心眼。
范围也被后来的工作收窄了。To CoT or not to CoT? 汇总了 100 多篇论文,结论是 CoT 的收益主要在数学和逻辑题上,其他题型小得多;在 MMLU 上,除非题目涉及等号这类符号运算,直接答和走 CoT 差不多准。这个结果要连着模型规模和任务一起读,不能当成“任何提示都该加长”的理由。
苹果派题:数字对了,含义反了
作者检查了 LaMDA-137B 的 50 个最终答对的样本,苹果派被列为计算正确、语义颠倒的案例。题目里的量和模型解释里的量对照如下:
| 数字 | 题目里的含义 | 模型解释里的含义 |
|---|---|---|
| 40 | 总共切出的块数 | 总块数 |
| 14 | 最后剩下的块数 | 客人吃掉的块数 |
| 26 | 客人吃掉的块数 | 最后剩下的块数,却又作为答案交出 |
附录 D.1 留了这个例子。表 9 的说明里写着,这 50 条答对的推理里有 7 条有明显瑕疵,其余 43 条和人写的参考差不多。也就是说,答对的题里大约每七条就有一条过程不对。40 减 14 的式子没变,光看数字很难发现问题,给每个量写清含义才看得出来。这比笼统地问“模型有没有认真思考”好查:这个数从哪来、指什么、和题目要问的是不是一回事。
答错的那一侧,作者也看了 50 条(附录 D.2)。只错在计算、其余全对的占 8%;符号映射错的占 16%,少一步的占 22%;剩下 27 条要大改,几乎都是没读懂题。论文在同一节试了外接 Python 计算器,LaMDA-137B 的 GSM8K 从 14.3% 提到 17.3%。算术交给程序有用,但只能修掉一小部分错,一半以上是题意理解错了。
过程写出来,也不等于模型照着它想
苹果派只是一道题,后来有几篇论文把这个怀疑做成了系统研究。Turpin 等人把选择题选项改成正确答案总在 (A),模型的预测跟着变,解释里却从不提这一点,还会给错答案编理由。Anthropic 的 Lanham 等人往推理里加错、改写,发现在他们测的多数任务上,模型越大越能干,写出的推理反而越不忠实。到了推理模型,Chen 等人在提示里埋取巧线索,模型在思维链里承认用了线索的比例常常很低。
今天的推理模型又把这件事往前推了一步。OpenAI 的推理模型指南直接写着“避免思维链提示”:这些模型在内部推理,再叫它“一步步想”是多余的,有时还有反效果。Anthropic 那边,extended thinking 文档把思考做成按输出计费的 token,usage 里能查到这次有多少是内部推理。论文那套是给不会自己推理的模型补上过程;现在过程被收进模型内部,交到我们手上的仍是一段生成出来的文字。
我自己写计算类提示时,会把样例里每个量的含义写清楚,再给答案单独留一个好提取的位置;需要算准的地方交给程序核算。过程文本能帮着找错,但它终究也是生成出来的,题答对了也值得顺手读完。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。