先定义中间状态,再生成、评价、选择,一棵搜索树要的就是这几步。
4、7、8、8 怎么算成 24?这是我自选的例子:先用两个 8 相除得到 1,剩下 4、7、1;再算 7 减 1,最后 4 乘 6。第一步只得到一个 1,看不出离 24 更近,但这条路走得通。
Tree of Thoughts 就是把这种中间状态也拿出来比较。模型不必先写完一整条解法,系统可以保留几种开头,挑有希望的继续,走不通再换。理解这个方法,我觉得先把程序要保存什么写出来,比先看一棵复杂的树容易。
先写清楚状态是什么
起始:4, 7, 8, 8操作:8 / 8 = 1剩余:4, 7, 1操作:7 - 1 = 6剩余:4, 6操作:4 * 6 = 24同一层还能暂存另一种开头:8 - 4 = 4,剩下 7、8、4,接着用 7 - 4 = 3、3 * 8 = 24 也能完成。两个开头先留在同一层,下一层分别从它们继续生成操作,分支就是这样分开的。这两条是我写的,不是原论文的采样记录。
每做一次运算,取走两个数、放回一个结果。剩余数字加上之前的操作构成状态;只有最终算到 24、且满足原数字的使用规则,才算完成。一步怎么算、状态里留什么写清楚了,程序才知道候选之间在比什么。
一步该切多大,论文 §3 给了个判据:thought 要小到模型能采出多样的候选,又要大到模型能评价它有没有前途。按表 1,24 点的一个 thought 是一行算式,填字是几个词,创作是一整段写作计划。作者还顺手把 IO、CoT、CoT-SC 都算成 ToT 的特例,只是树又浅又窄。
半成品靠模型估计可解性来比较
论文让模型提出候选操作,也让模型估计后续是否可解,用 sure、likely、impossible 这类判断(§4.1 叙述里写作 maybe)指导搜索。24 点只在终局分对错:四个数算到剩一个,中间只有三步,这些半成品数字本身不分成败,要让它们参与比较,靠的就是这层估计。保存状态、选择分支、检查最终表达式由外部程序负责。
这层估计到底有多粗,看作者代码里的评价提示就知道:三档 sure、likely、impossible 没有定义,全靠几个例子教。“10 + 14 = 24”判 sure,“数字在合理范围内”判 likely,“10 10 10 都太大”判 impossible。§4.1 说得也直白:靠“太大、太小”这类常识剪掉不可能的分支,其余先留着。
评价也会错。比如把上面得到 1 的分支过早丢掉,后面就再没机会沿它走到 24。分支多了,机会也多,但每个机会都要过同一道评价。
为什么值得冒这个险,§4.1 有个诊断:约 60% 的 CoT 样本在第一步之后就已经错了。一条路走到底,开头错了就全废;留几种开头,至少还有得选。
不过附录 B.2(表 5、表 6)显示,24 点的瓶颈其实不在评价。GPT-4 生成、GPT-3.5 评价能到 64%;反过来 GPT-3.5 生成、GPT-4 评价只有 31%。评价弱一档还撑得住,提不出好候选才是大问题。
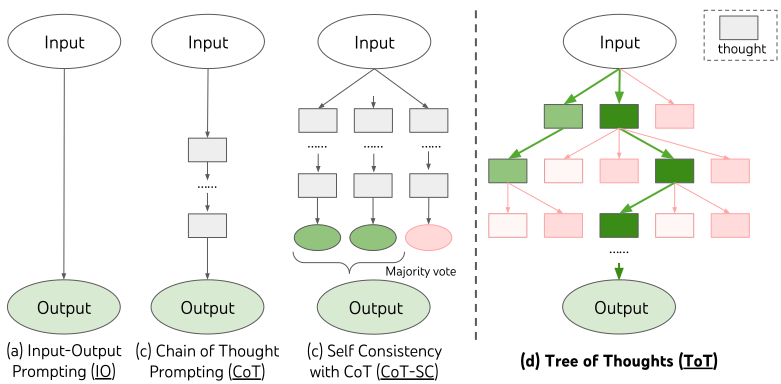
图源:论文 Figure 1,版权归原作者。ToT 的选择发生在完整答案出现之前;Self-Consistency 则是先生成完整解,再统计终点。
宽度从 1 到 5,成功率从 45% 到 74%
24 点实验用 BFS,每层留下若干状态分别扩展。宽度 1 只留一个;宽度 5 让五种中间情况继续竞争。GPT-4 在 100 道较难题上的结果:
| 方法 | 成功率 |
|---|---|
| CoT | 4% |
| CoT-SC(采样 100 条完整解法) | 9% |
| ToT,宽度 1 | 45% |
| ToT,宽度 5 | 74% |
“较难”有具体出处(§4.1):题目来自 4nums.com 的 1362 道题,按人类解题时间从易到难排,论文取的是第 901 到 1000 题。同一张表 2 里还有几行:CoT 采样 100 条取最好的一条,也只有 49%。多试 100 次,还是差 ToT 一大截,差别在中途选择,不在试的次数。
还有一点要提:作者仓库的 README 说,有一个实验文件重跑得到 69%,不是 74%,原因是 GPT 解码的随机性。74% 是一次跑出来的数,不是稳定值。
这组实验 里,选择发生在中途,代价是额外生成和评价候选,不是在提示末尾加一句话就能白拿的提升。留的状态越多,下一层要生成、评价的次数也越多,宽度开大,多花的正是这部分。
附录 B.3 表 7 把账算出来了:ToT 每道 24 点题约 5.5k 生成 token、1.4k 提示 token,大约 $0.74;CoT 采样 100 次取最好,约 $0.47,换来 49%。ToT 用的 token 已经接近跑 100 次 CoT。
什么时候不值得搜
论文 §6 自己划了边界:GPT-4 已经擅长的很多任务,用不着刻意搜索;搜索比采样更费钱;这项工作也只测了三个相对简单的任务。附录 B.1 表 4 给了例子:GSM8K 上 CoT 86%、ToT 90%,StrategyQA 上 82% 对 83%。作者说 StrategyQA 的瓶颈在外部知识,不在推理,中途选择帮不上忙。
模型弱了也救不回来。附录 B.2 里,同样的 ToT,GPT-4 是 74%,GPT-3.5 只有 19%。
后来的实证把评价这道关卡说得更重。ACL 2024 的一篇论文把规划拆成生成器、判别器和规划方法,结论是树搜索这类方法要判别器足够准,才能明显胜过简单的重排序;当时的 LLM 判别能力不够,树搜索慢了很多,收益却几乎没有。我的判断是:用 ToT 之前,先确认你有一个靠谱的评价,24 点有,大多数开放任务没有。
换个任务,状态就得重新定义
DFS 的安排不同:先沿一条分支往深处走,遇到不合适的状态再退回来。迷你填字任务里,状态是当前格子和已填单词,一个词放进去会限制交叉位置;创意写作则可以把计划当作 thought。这些任务没有统一的一步长度,生成和评价方式要按任务单独定义。
填字任务的消融(§4.3 表 3)能看出 DFS 里每个部件值多少。整局成功率 ToT 20%,去掉剪枝 5%,去掉回溯也是 5%。原因之一是 5×5 填字里有些生僻词 GPT-4 不认识,评价器会把它们误判成 impossible 剪掉。作者的结论是,更好的剪枝启发式对这个任务至关重要。
创作任务(§4.2)又是另一套:先生成 5 个写作计划,让模型投票选一个,再对段落做同样的投票,宽度只有 1。评价从打分换成了投票。人评 100 组段落,41 次更喜欢 ToT,21 次更喜欢 CoT。
树后来也被改造过。Graph of Thoughts 把 thought 当成图的节点,可以合并多个 thought,这是树做不到的。LATS 把蒙特卡洛树搜索、价值函数、反思和环境反馈接到 agent 上。LangGraph 的 LATS 教程里,每步按 UCT 选节点,展开 5 个候选并行执行,再用反思模型打分回传。“生成、评价、选择”三件事都还在,选择从 BFS 打分换成了访问计数和回传。
所以照着作者代码做小实验(run.py 实现了 ToT + BFS,logs/ 里有论文实验的全部轨迹可以对照),先挑 24 点这种状态明确的任务:剩余数字是什么、最终表达式怎么验证,都清楚。换成长文,要保留的是一个词、一段提纲还是整份草稿,得重新决定,不能把 24 点的状态改个名字接着用。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。