从报告编号回查原文要走五步;再看 GraphRAG 的胜率口径、省下的 token 和提前付的索引账。
GraphRAG 生成的回答,引用里可能写着 Data: Reports,后面跟着报告编号。这个编号指向系统事先写好的社区报告,离原文还有距离。想确认一句话是不是资料里真说过,还得往回走好几步。
global search 读的是报告,不是原文
GraphRAG 的 global search 分两段:
- 提问之前:把语料加工成实体和关系,做层级社区发现,再给每个社区生成报告;
- 提问时:把某一层的报告分组,各组生成局部回答,再汇总成最终答案。
它适合回答一批资料的整体主题,比如大量访谈里反复出现了哪些问题。代价是它读的材料经过了不止一次整理。
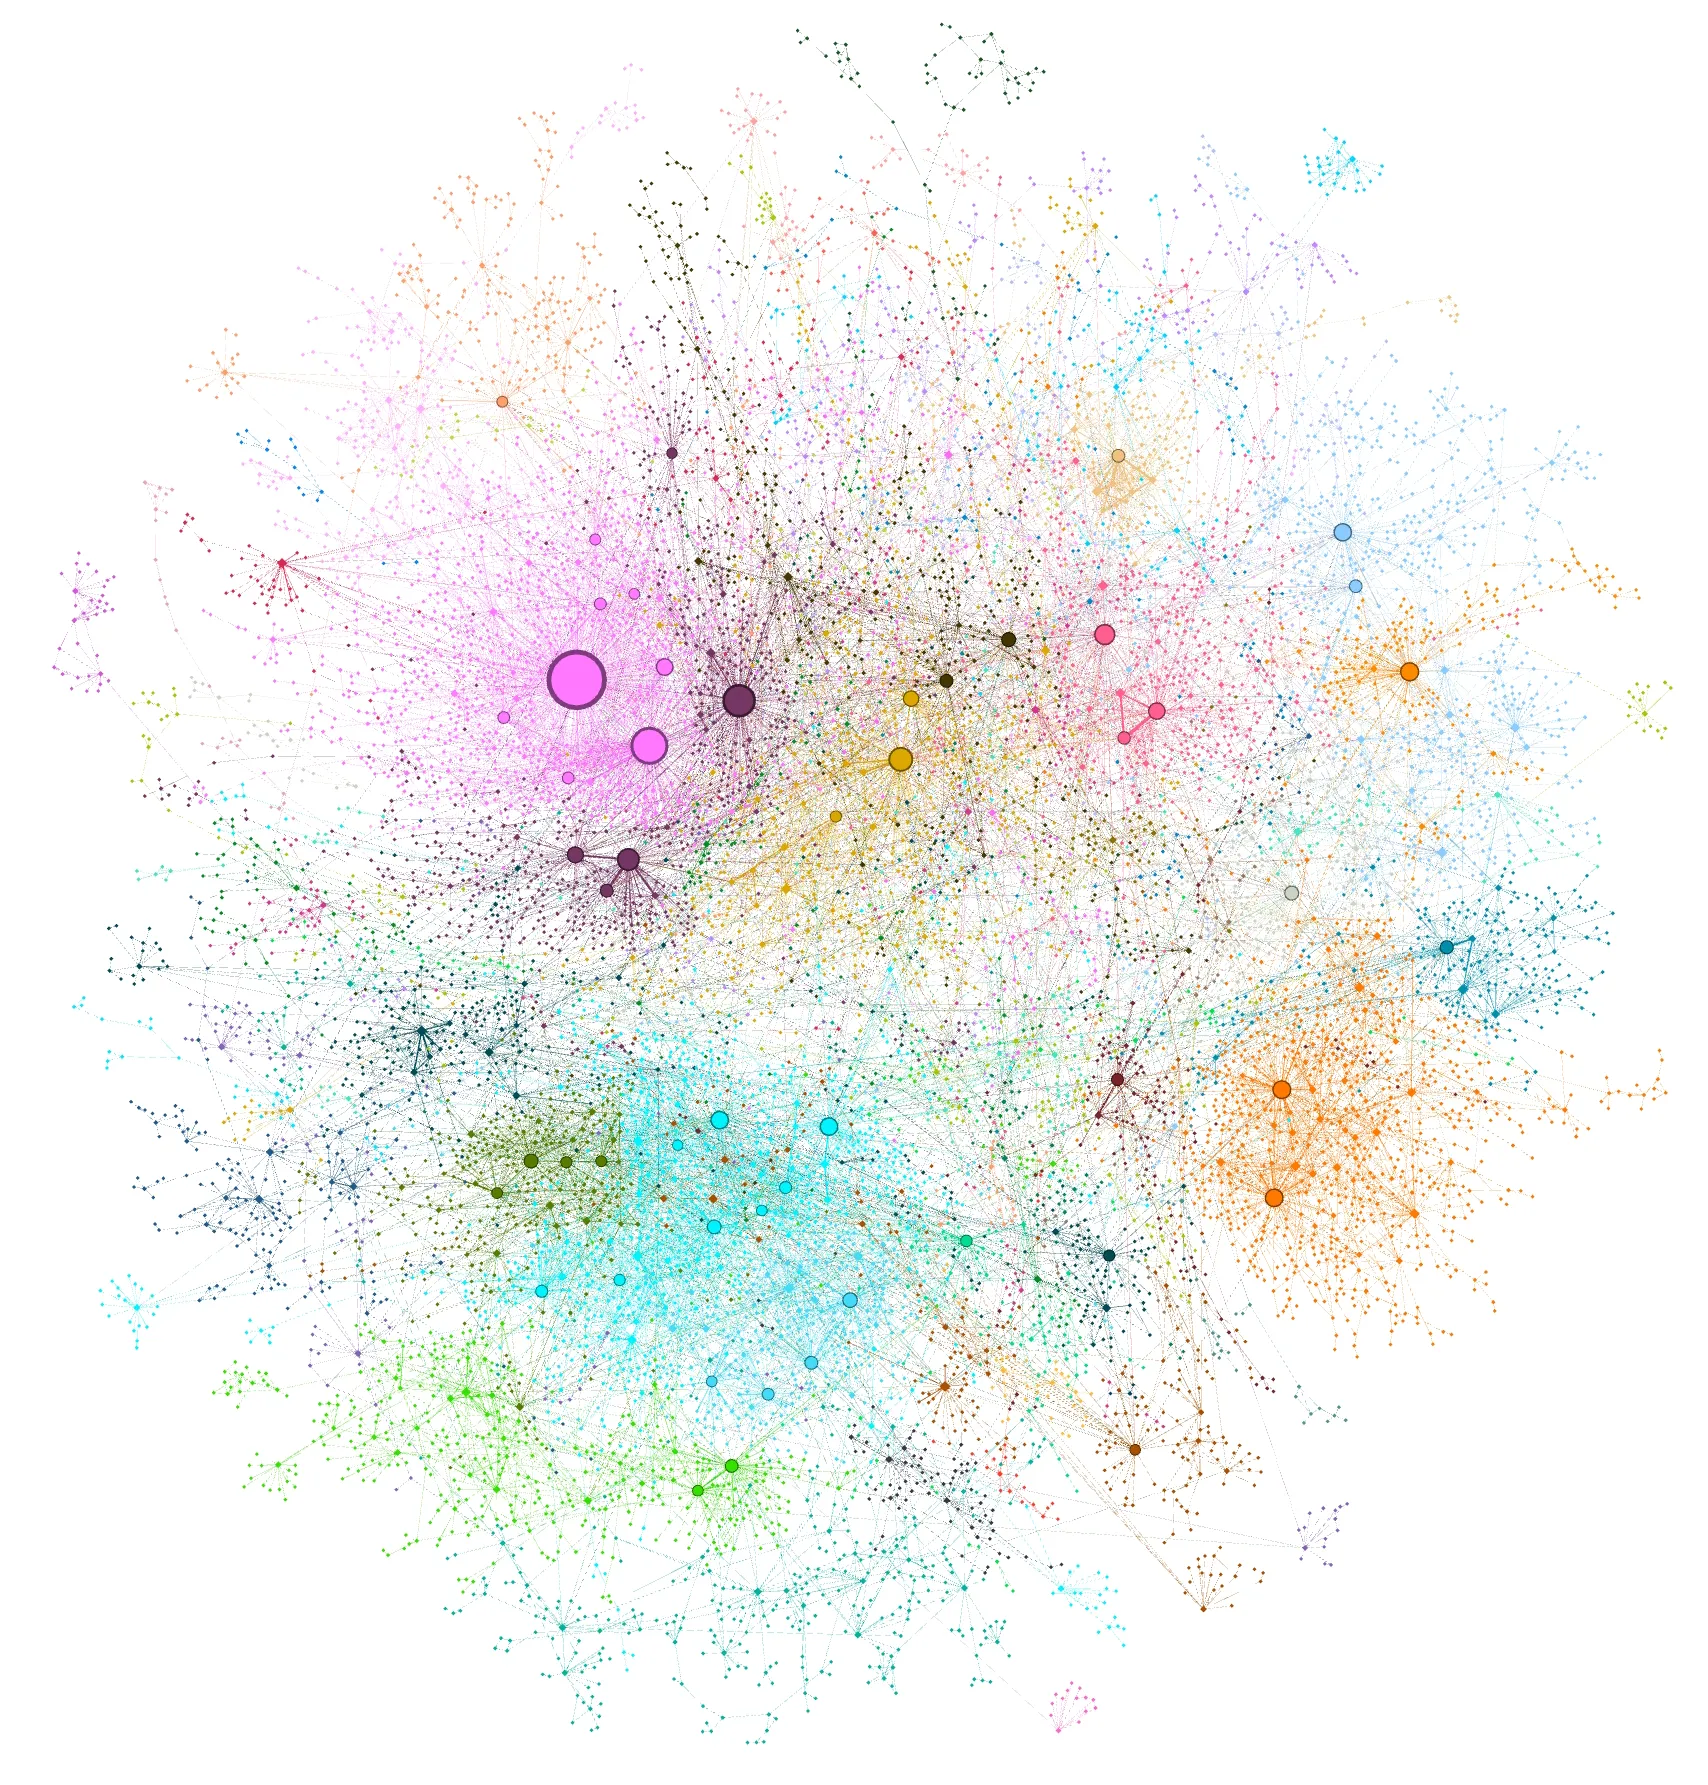
图源:原论文 Figure 4,版权归原作者。这里的社区是图中连接较密的节点分组。
从报告编号回到原文,要走五步
我想把引用这条路单独记下来,因为它决定了汇总之后还方不方便核对。按官方早期 v0.1.1 的结构,可以这样查:
最终答案中的报告编号 → 社区报告 → 报告所引的实体、关系等记录 → 记录关联的 text_unit_ids → 原文文本块及 document_ids → 来源文档map 提示 要求局部结果给出描述、重要性分数(0–100)和报告引用(论文附录的最终答案提示用的是帮助分),reduce 提示 汇总时保留引用。社区报告里又可以引用实体、关系或声明的记录 ID,这些编号不是原文页码,也不能直接当数组下标。两个提示还规定单条引用最多列 5 个编号,多的写成 +more。所以读者看到的引用是截过的,未必是全部依据。
报告本身也不只是转述。生成报告的提示要求五段:标题、摘要、影响严重度评分、评分理由、详细发现。严重度是模型自评的 0–10 分,原文里没有这个东西。它给的引用示例长这样:
[Data: Reports (1), Entities (5, 7); Relationships (23); Claims (7, 2, 34, 64, 46, +more)]这里容易和图那一层搞混:社区怎么分、报告怎么写,都在提问之前完成;提问时系统读的是报告文本,回查则顺着报告里记下的编号往下走。层越高,社区越大,一份报告覆盖的资料越多,但核对仍要落到这份报告引用的具体记录上。
几个字段要分清:
- 引用里显示的编号是记录的
short_id,先按它找到记录,再沿内部关联查。它和内部id是两回事,见 Identified 定义,不能拿显示编号直接当内部 ID 去查文本块。更容易误会的是,拼上下文的代码给模型的表格第一列放的是short_id,表头却写着id,CSV 还关掉了行号。 - 实体 和关系保留了
text_unit_ids,靠它找到 TextUnit 的文本和文档关联。
这样读者看到一句关于某个实体的概括,至少有路可以回到被抽取的段落。这份笔记对照的是早期版本,接口后来变了就得重查字段。
现在官方版本到了 3.3.0,README 说项目基本进入维护状态。输出表还叫 community_reports,声明不再叫 claims,挪进了可选的 covariates 表;global search 之外又多了一种 DRIFT 搜索。global search 文档只讲用社区报告做 map-reduce,没提引用怎么回溯。这条回查路至今只存在于代码的字段关系里。
编号存在,只是核对的第一步
报告可能引用了一条真实的关系,写出的解释却超出了那条关系;最终答案也可能把局部结论概括得太宽。沿这条路回查,才分得清原文说了什么、抽取写了什么、哪一层开始多说了一点。
“抽取写了什么”本身就会变。论文附录 A.2 让模型回看自己的抽取结果、补漏掉的实体,迭代多轮;同一份 HotPotQA 材料上,600 token 分块抽出的实体引用数接近 2400 token 分块的两倍。换个分块大小,同一段原文就长出不同的图。点开引用如果只落到另一份 AI 摘要,读者的核对就还没完成。
实验:比向量检索全面,和 TS 基线互有高低
原论文用两份语料,约一百万和一百七十万 token 的播客转录与新闻材料,每份生成 125 个全局问题,再让模型两两比较答案(实验部分)。对照组除了普通向量检索,还有直接对原始文本做 map-reduce 的 TS 基线。这个对照很必要,不然“更全面”可能只是因为看的内容更多。
| 对比对象 | GraphRAG 的表现 |
|---|---|
| 向量检索 | 全面性、多样性更好 |
| TS(原文 map-reduce) | 部分中低层报告有较小提升,根层并非一直更好 |
这些都出自论文自己的实验设置,我没有复现。
细看 §5.1 和附录 G,数字比表格更有意思:
- 对向量检索,全面性胜率播客 72–83%、新闻 72–80%,多样性 75–82% 和 62–71%;但“直接性”上向量检索的回答最直接,empowerment 一项有输有赢。
- 播客全面性上,根层报告对 TS 是 50.24 对 49.76,p=1,就是打平。TS 赢向量检索的幅度(83.12 对 16.88)比任何一层报告都大。“比向量检索全面”这件事,直接对原文 map-reduce 也能做到。
- 报告各层之间的六组两两比较全部不显著。
还有一个边界。§3.2 生成 125 道题的规则要求题目“需要理解整个语料”且“不需要检索具体的低层事实”。所以报告能不能回到原文某一段,从头就不在这篇论文的测量范围里,胜率回答不了。论文自己的第二套测法(把答案拆成事实主张来数)和模型两两判分,全面性上也只有 78% 一致。
后来的独立评测也不乐观。GraphRAG-Bench 开头就写,近期研究报告 GraphRAG 在很多真实任务上常常不如朴素 RAG,于是去找图结构到底在哪些场景有可测的收益。
省下的查询成本,是提前付过的
最低层报告的查询上下文比直接处理原文少约 26% 至 33%,但抽取和生成报告的开销在查询之前就付了。
省多少取决于取哪一层。论文 Table 2 的账:
| 语料 | 原文 | 根层报告 | 最低层报告 |
|---|---|---|---|
| 播客 | 1,014,611 | 26,657(2.6%) | 746,100(73.5%) |
| 新闻 | 1,707,694 | 39,770(2.3%) | 1,140,266(66.8%) |
根层省 97% 以上,代价是报告更粗;而根层在全面性上又只和 TS 打平。索引那头论文只给了一个墙钟时间:播客语料 1669 个 600 token 的块,用 gpt-4-turbo 建图花了 281 分钟(§4.1),没算 token 和钱。微软后来在 LazyGraphRAG 的博客里说,它的索引成本和向量检索相同、只有全量 GraphRAG 的 0.1%。反过来读,全量 GraphRAG 的索引大约是向量检索的一千倍,这是自家博客的口径。节省来自把原文加工成可以反复使用的报告,所以原文到报告的关联也值得一起存好。前期开销能不能摊回来,要看同一份语料会被问多少次。论文 §6.2 提的下一步是按需临时生成社区报告,那样读者以后点开引用,更常落到的会是一份刚生成的摘要,回查到原文的这条路就更该存好。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。