12 人受邀、5 人到场:知道、想去和真去之间,差的是哪一环。
Smallville 的咖啡馆要办情人节聚会,12 个角色收到邀请,最后来了 5 个。比起小镇里的人互相聊天,这个数反而更让我想往下读:没来的七个人是忘了、临时有事,还是程序只让他们嘴上说愿意,却没安排后续?
没来的七个人,不都是“忘了”
Generative Agents 后来真去问了这些角色:
- 三人有时间冲突,其中画家 Rajiv 在忙着准备展览,没空再安排情人节活动;
- 四人说自己有兴趣,但当天没把赴约写进计划。
Rajiv 的理由是访谈里的原话:
I’m focusing on my upcoming show, and I don’t really have time to make any plans for Valentine’s Day.
所以不能把七个人统称为“忘记了”。至少从系统留下的回答看,有安排冲突,也有从意愿到计划没接上的。这些数字和回答都来自论文的社会行为观察(§7.1.2),我没有复现。
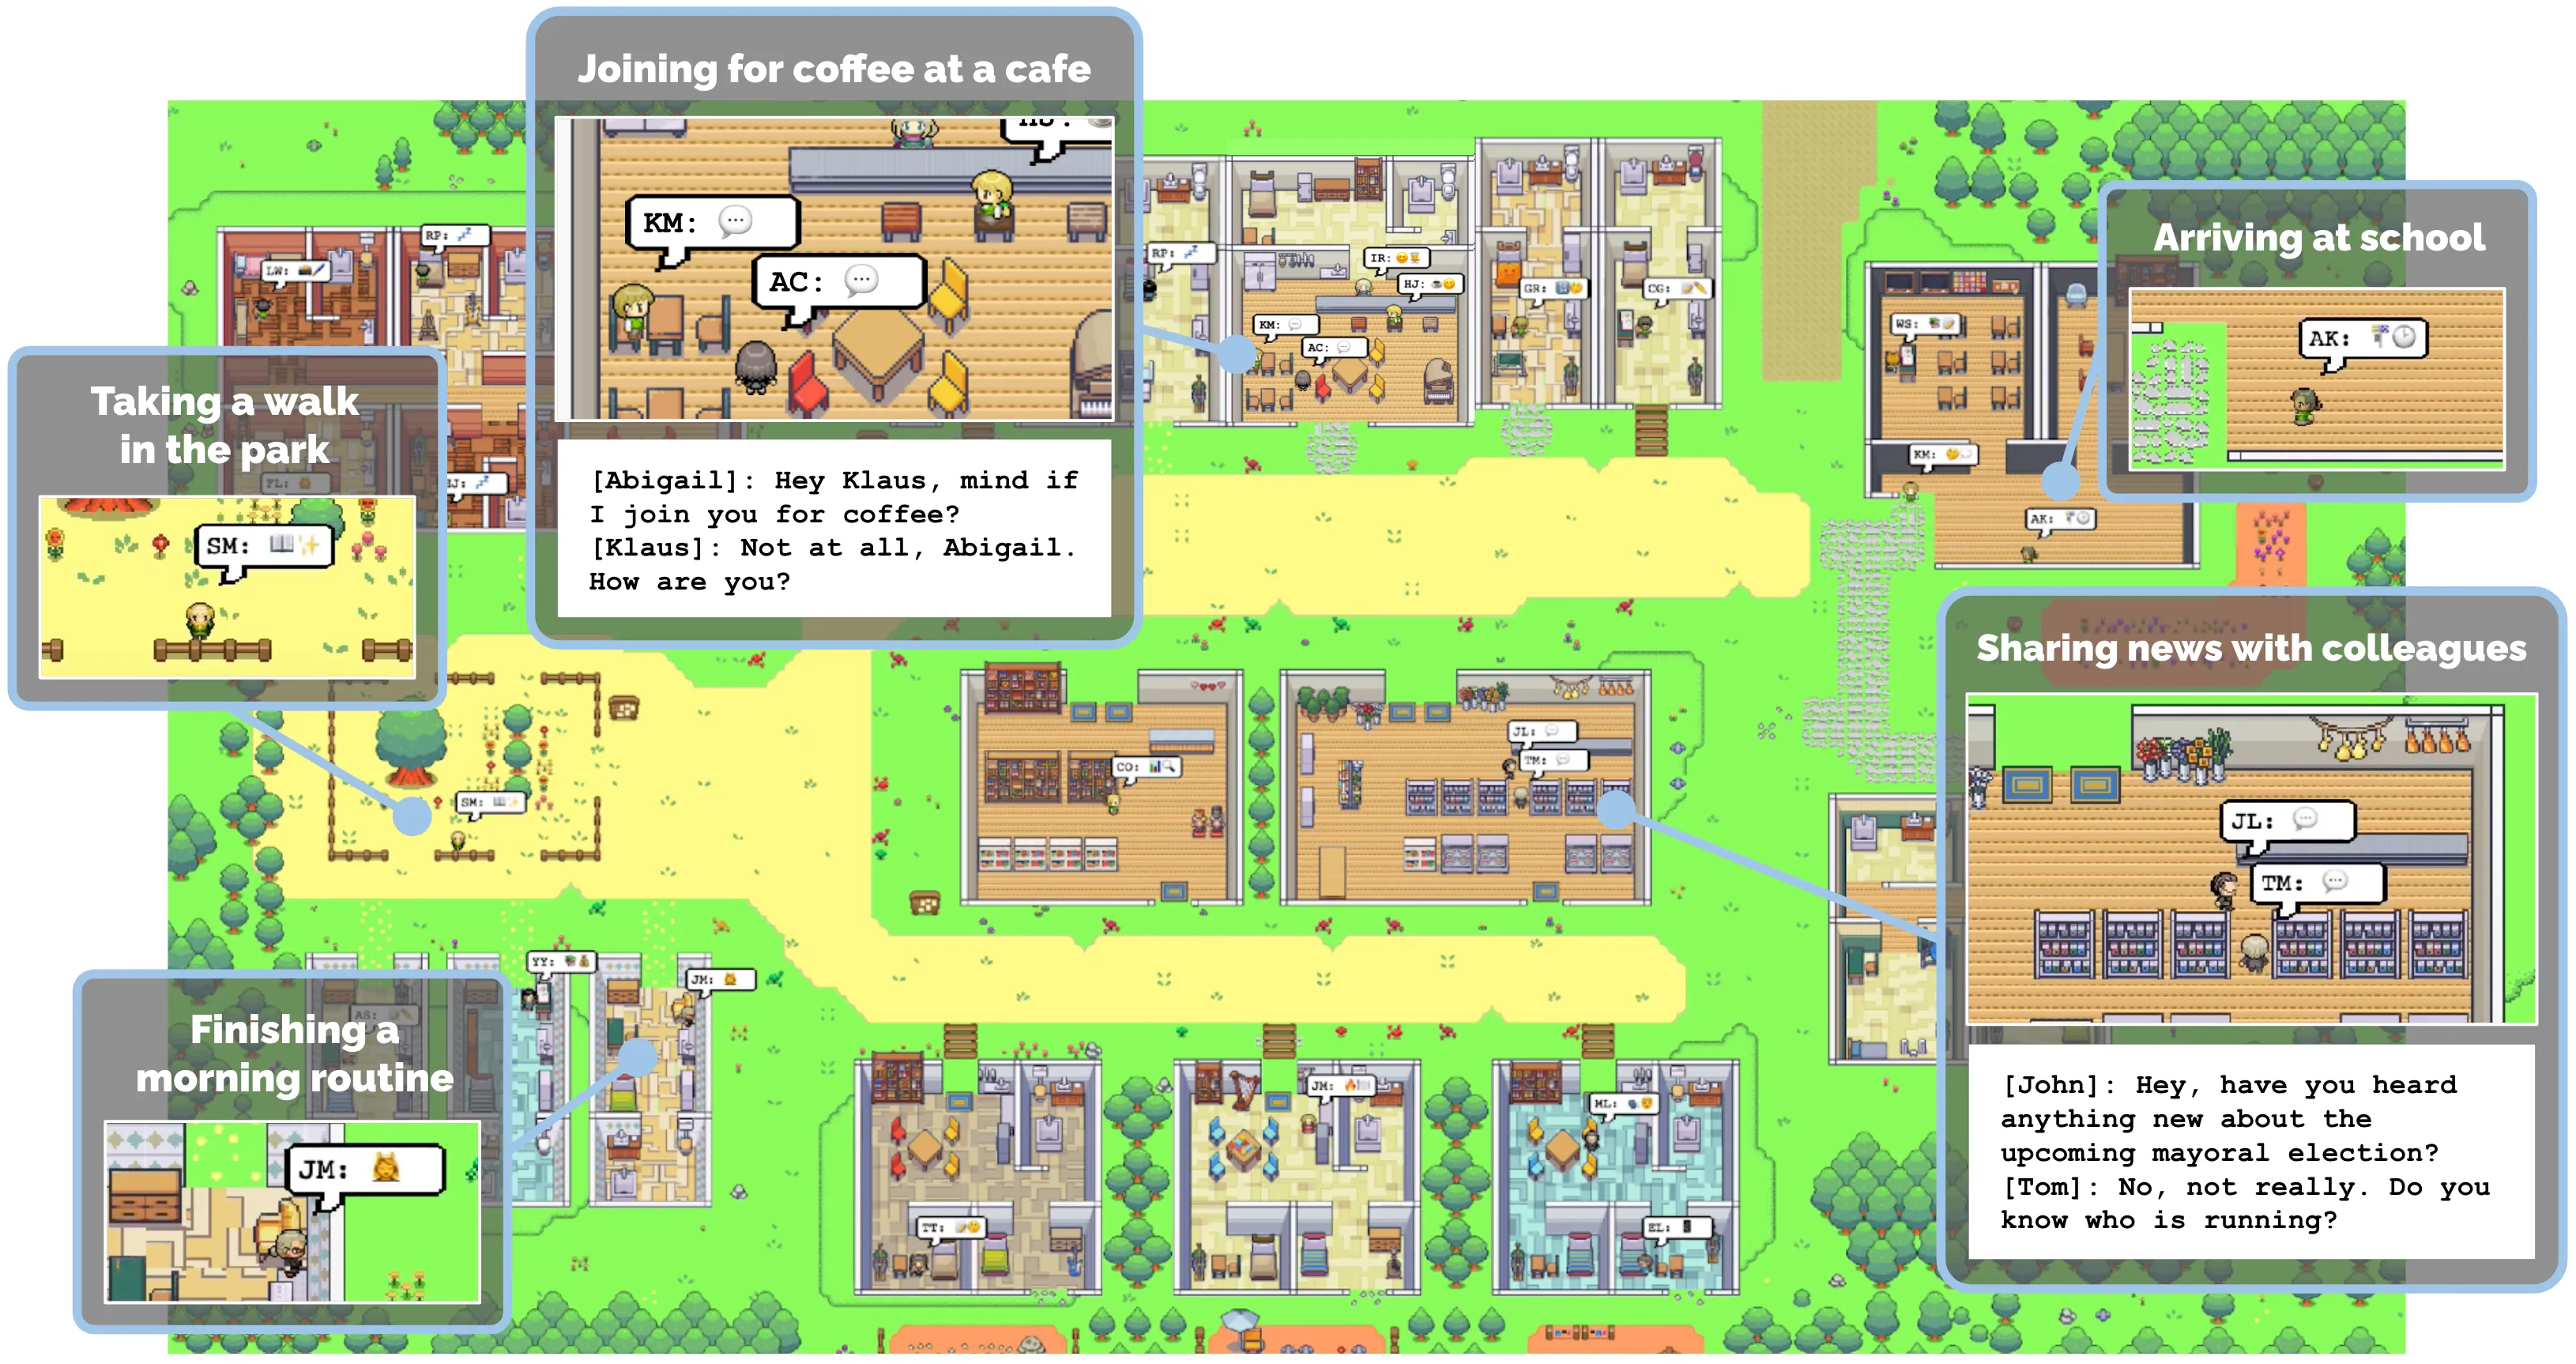
图源:论文 Figure 1,版权归原作者。
小镇有 25 个角色,研究者给了他们初始背景,也给了咖啡馆经营者 Isabella 一个办聚会的意图。两天模拟里,消息靠交流传开,知道聚会的人从 1 个(4%)变成 13 个(52%)。这里的“知道”按交流中听说过来统计,不等于收到邀请,更不等于答应到场。论文还专门核查过有没有角色假称知道,结论是没有一个是编出来的(§7.1.2)。
人物会聊天当然显眼,但要让聊天影响下午去哪,消息得先存下来,安排活动时再取出来。
一句邀请要走完记忆、规划、执行三段
系统把观察、对话和行动写进 memory stream。决定下一步时,按三个分数挑一部分记忆:
| 分数 | 看什么 | 论文里怎么算(§4.1) |
|---|---|---|
| 相关性 | 和眼下的处境对不对得上 | 查询与记忆的余弦相似度 |
| 近期程度 | 隔了多久 | 按距上次被检索的游戏内小时数指数衰减,因子 0.995 |
| 重要性 | 这件事本身的分量 | 让模型直接打 1–10 分 |
三个分数先各自 min-max 归一,权重 α 全设为 1,加起来排序。取多少条也没有固定的 top-k:排在前面的记忆,能塞进上下文窗口多少就塞多少。
所以一句邀请进入历史后,并不会马上变成要执行的日程。模型规划一天时要先取到相关信息,把活动放进安排,再逐步拆到小时、拆到五至十五分钟的动作;环境程序接着执行移动和物体操作,人物才会真的出现在咖啡馆。
按 §4.3 的写法,第一层是把一天切成五到八块的粗计划,每条计划带地点、开始时间和时长,计划本身也写回记忆流,必要时可以中途改。也就是说,“去咖啡馆”要变成一条有地点有钟点的记录才算数,嘴上答应不算。
那四个有兴趣却没列进计划的人,被问“想不想去”时可以答想去;但要在具体时间改变行动,得靠规划产出一次赴约。论文没有替这四人逐一找到出错的那条记忆权重,所以不能猜是哪个召回参数造成了缺席。能确定的是,检查范围可以从笼统的“Agent 不记事”,缩到邀请怎样进入计划这一段。
消融数字:规划这一环最不能省
论文的消融(§6.5.1、Figure 8)让 100 名真人在五个条件之间比较访谈回答的可信度,用 TrueSkill 打分:
| 条件 | TrueSkill μ |
|---|---|
| 完整架构 | 29.89 |
| 去掉反思 | 26.88 |
| 去掉反思和规划 | 25.64 |
| 人类众包写手 | 22.95 |
| 观察、反思、规划全去掉 | 21.21 |
每去掉一层,分数就掉一档,去掉规划之后掉到 25.64,比只去反思再低一截。这和聚会的观察对得上:“知道”这一步问题不大,缺的往往是“排进日程”。要注意这是对访谈回答的可信度评分,不是到场率这类任务指标。
另一个数字也指向同一处。在 453 条关于其他角色的回答里,被判为幻觉的只有 1.3%(6 条),§6.5.2 的小标题就叫“Generative Agents Remember, but With Embellishments”。记忆本身很少凭空编造,更多是在真实记忆上添油加醋。所以我更倾向把问题放在“怎么用记忆排计划”,而不是“记忆坏了”。
画像写得再丰富,也替代不了几点去哪
系统还有反思:把一些观察概括成更高层的判断,记下所依据的记忆编号,供后续使用。比如角色多次接触某个主题,反思可以概括出他的兴趣,这和保存每次原话是两种用途。记下编号,每条概括都能回到它依据的那几次观察,不会只剩一句没出处的判断。
机制本身很朴素(§4.2):
- 最近事件的重要性分数累加超过 150,就触发一次反思,实际每天两三次;
- 拿记忆流里最近 100 条记录,先让模型提 3 个最突出的高层问题;
- 再按这些问题检索,要 5 条高层洞见,每条带着指向所依据记忆的指针;
- 反思还能再引用反思,长成一棵“反思树”。
反思能帮人物在一段时间里保持行为倾向,也可能添出不够准确的印象。聚会这件事提醒我:角色画像写得再丰富,也替代不了“某天几点去哪”这样的具体安排。
五个人之外,论文自己认的错
旧的解释只盯着召回,论文 §7.2 “Boundaries and Errors”其实还列了三类跑歪的情况:
- 记忆越攒越多,检索和选址变差,有角色午饭跑去了酒吧;
- 物理和社会规范没写清就会判断错,比如不知道店几点关门还往里走,把宿舍浴室当成公用的;
- 指令调优让角色整体“更有礼貌、更配合”,Isabella 几乎不拒绝别人的提议,久而久之自己的兴趣被别人带着走。
第三条最有意思,它恰好落在聚会发起人身上。一个几乎不说“不”的角色,能把消息传给很多人,却未必能让别人把她的事排在自己的事前面。这只是我的联想,论文没把它和到场率连起来。
§8.2 的局限也值得记一笔:评测只在较短的时间尺度和一个众包基线上做过,而且记忆可以被攻击,一段精心构造的对话就能让角色相信一件从没发生过的事。既然一句邀请能顺着记忆走到计划里,一句假话也能。
跑一个小镇要多少钱,后来又变成了什么
聚会意图和人物背景是研究者设的,之后消息怎么传、人物怎么安排活动,留下了可以观察的过程。公开代码与演示里,一句邀请要经过收到消息、规划日程、执行移动,人物才会走进咖啡馆。
代价不低。论文用的是 gpt-3.5-turbo,25 个角色跑两天就花掉“数千美元的 token 额度”,还要跑好几天(§8.2);附录 A 给的省法是低层计划临近时才展开、缓存角色概要。代码仓库的 README 也说得直白:要自己在 utils.py 里填 OpenAI key,触到每小时限额 API 会挂住、可能得重启模拟,角色多了费用不小。
今天最直接的工程化版本是 a16z 的 AI Town,README 写明受这篇论文启发,改成 JS/TS 框架,后端用 Convex 管共享状态和向量检索,默认跑本地 Ollama 上的 llama3。论文里“能塞多少记忆就塞多少”,在这里变成了 constants.ts 里的 NUM_MEMORIES_TO_SEARCH 一个常数;页面空闲 5 分钟模拟就暂停,成本被显式管了起来。
学术上有两条方向相反的后续:
- 同一作者组把方法搬到访谈驱动的个体模拟:1052 名美国人,用访谈建的角色在问卷上的回答,分别达到被试自己两周重测一致性的 83%(只用访谈)、82%(只用问卷)、86%(两者合用),只用人口学信息的只有 74%。
- Taillandier 等人批评这类工作主要评估涌现行为“可信、自洽”,而不是它和真实数据对不对得上。
我觉得两条都站得住。Smallville 证明了“像人”可以做出来,十二个人来五个的结果也很像人;但像不像真实小镇里的人,这篇论文没测,也不打算测。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。