一条报销规定可能死在切块、重排或过期版本上:对照综述和后来的工具,逐步排查。
“提前一天到达,住宿可以报销吗?”
假设知识库里的规定是这样的。例子是我编的,方便把检索过程摊开看:
会议参加者提前一天到达,可以报销当晚住宿。须提供主办方书面日程,以证明提前到达的必要性。住宿限额按会议所在城市的类别执行,见附表二。只把第一句交给模型,它回答“可以”顺理成章。问题出在材料进模型之前:后面的凭证要求和限额没跟着过来。整份文件还在,相关段落也找到了,为什么偏偏少了下面两行?这时我会先去看切块结果。
我觉得 Gao 等人的 RAG 综述 适合放在这样的排查过程旁边读:先把这条规定完整送到答案里,再决定改哪一步。
先看模型究竟收到了什么
如果三句话本属同一条款,却被固定长度切块拆开了,办法有两个:切块时保留条款边界,或者命中第一块后把相邻内容补回来。第三句还指向附表二,附近的文字未必包含那张表,得再找一次。只把每次召回的数量调大,可能混进别的会议的报销说明,未必正好补齐。
这两个办法综述都算在索引期的切块里。§III-B1 说最常见的是按固定 token 数切(100、256、512),代价是切在句子中间;补救之一叫 Small2Big,用句子做检索单元,前后句作为上下文一起给出。今天它已经是现成组件:LlamaIndex 的 SentenceWindowNodeParser 按句切,把邻近句子存进 metadata(文档说这部分对嵌入模型不可见),命中后再由 MetadataReplacementNodePostProcessor 换成整段上下文交给模型。检索粒度没变,送给模型的变了。
Anthropic 的 Contextual Retrieval 是另一种补法:给每个块前置 50–100 token 的说明再嵌入。官方数字是 top-20 检索失败率从 5.7% 降到 3.7%,加上 BM25 和重排后降幅到 67%;配合提示缓存,一次性建索引成本约每百万文档 token 1.02 美元。这些是它自己配置下的数字,换到报销文件上还得重测。
召回数量往大调、或者整份放进去,其实是同一个粒度旋钮的两端。综述 §III-A2 的说法是:粗粒度能带来更多相关信息,也带来冗余;细粒度检索负担更重,还不保证语义完整。
另一种情况是三句话都召回了,重排后截取 top-k,却只留下第一句所在的块。检索有命中,送进提示的材料照样不完整。
这种情况有现成编号。Seven Failure Points 列的 RAG 失败点里,FP2 是答案在文档里但排得不够靠前、没被返回,FP3 是检索到了却没进入生成的上下文。凭证条件丢在哪一步,大致就对应其中一个。顺序也有影响:Lost in the Middle 发现相关信息放在输入开头或结尾时表现最好,放在中间明显变差,综述 §IV-A1 也提到有人把最相关内容挪到提示两端。
切块和重排管的不是一个范围:
- 切块发生在建索引时,决定哪些段落以后还能被召回;
- 重排和压缩处理已经召回的候选,没召回的内容,靠它们补不回来。
所以调试时我会同时保留召回列表和最终上下文,不能只看向量库返回的头几项就宣布检索没问题。综述把这些修改位置分在检索前、检索后等部分;重排和压缩各解决什么,可以去上下文整理一节找。
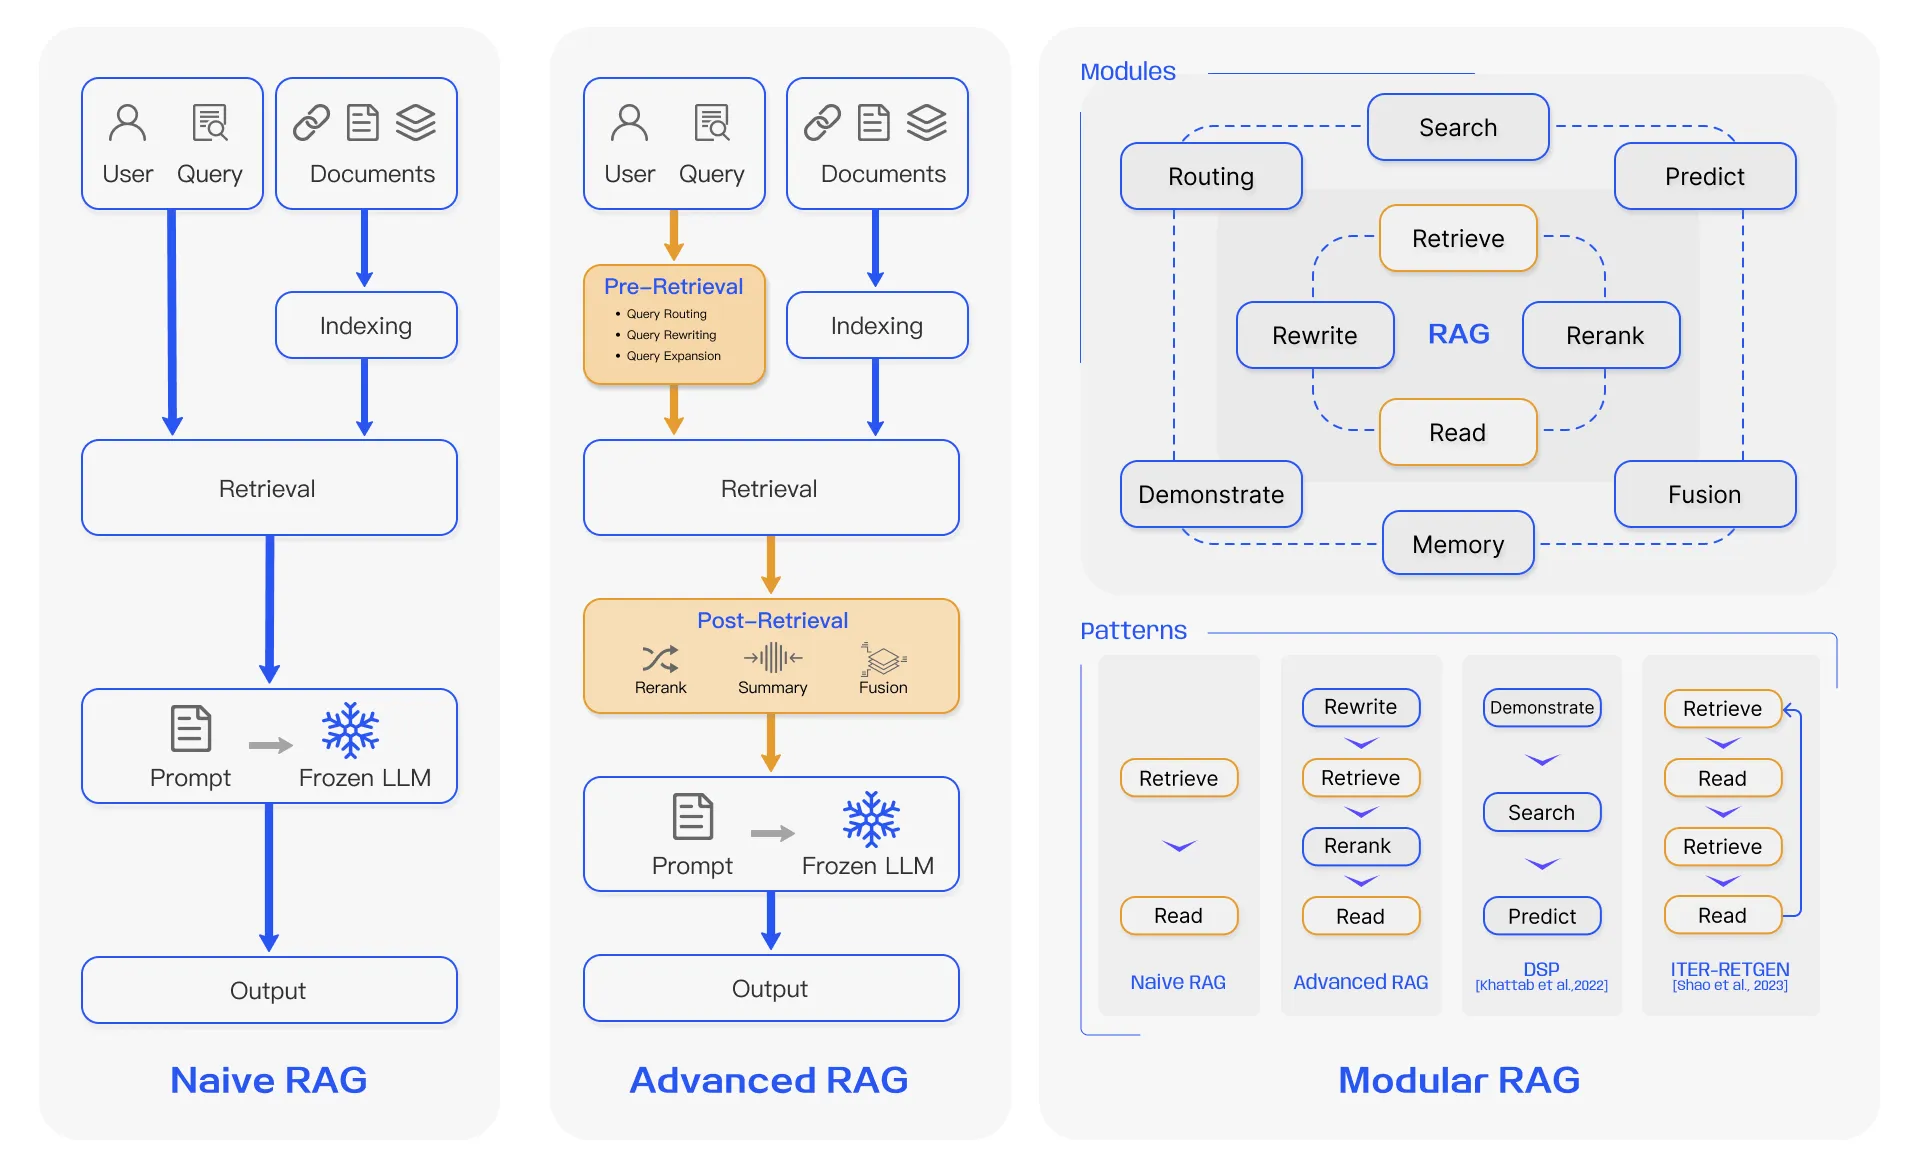
图源:论文 Figure 3,版权归原作者。图里的模块用来定位改动位置,实际项目不用全装一遍。
三种 RAG 范式,各对应哪处缺口
| 范式 | 做了什么 | 对这个例子 |
|---|---|---|
| Naive RAG | 索引、检索、生成 | 已经能把这份文件送进一次问答 |
| Advanced RAG | 加入切块、查询优化、结果整理 | 正好对应前面几处缺口 |
| Modular RAG | 把搜索、路由等组织成可组合的部件 | 还没理由直接画一套复杂路由 |
对这个小例子,先把条款和附表的关系保存好就很有用,还没理由直接画一套复杂的路由系统。
答案带了链接,还要查条件和版本
材料齐了,模型回答:“可以报销,详见会议管理办法。”链接指向正确的文件,读者却还是不知道要交书面日程。答案没捏造条款,照着办却可能少交一份材料。所以我会把“有没有带上凭证条件”单独列成一个检查项,和“引用是否存在”分开。
再把问题改一下:索引里只剩去年的规定,而今年这项报销已经取消了呢?模型可以非常忠实地引用旧文件。这是知识库版本的问题,faithfulness 这类检查回答与给定材料是否一致的指标,判断不了文件是否还有效。RAGAS 的定义是回答里的每个 claim 都能被检索到的上下文支持,它只管回答和这段材料对不对得上。
综述把这件事放在检索期。§III-B2 说块可以带文件名、类别、时间戳等元数据,检索时给时间戳不同权重,就能做 time-aware RAG。所以我会把生效日期写进 metadata,在检索时就把作废的版本滤掉,而不是指望模型自己分辨。知识冲突综述也说,模型到底优先信上下文还是参数里的记忆,目前没有定论。
综述的评估部分把检索质量和生成质量分开讨论,顺着这条线看,比只记一个最终分数有用。两类毛病要分开查:
- 凭证条件没进上下文:可能是切块时被拆走、召回时没命中,或者重排截取时被丢掉,三处改法不同;
- 材料过期:检索和生成可能都正常,要查的是版本,以及这份文件现在还有没有效力。
综述 §VI 给了两边的指标名:检索看 Hit Rate、MRR、NDCG,生成看 faithfulness、relevance;能力上分噪声鲁棒、拒答、信息整合、反事实鲁棒四项。凭证条件没进上下文,最接近“信息整合”这一项。不过 RAGAS 的指标页是一张平铺清单,没按检索、生成分组,用的时候得自己归类。RAGChecker 拆得更细,按 claim 算 precision 和 recall:回答漏了“须提供书面日程”,是 recall 缺口,faithfulness 照样满分。
排查就盯一句话在哪一步消失
这份说明要是总共只有两页,我也愿意先整份放进去,看答案能不能把条件写清楚。等它变成几千份文件,再去处理检索范围和版本筛选。
这个判断有实测撑着。一篇长上下文和 RAG 的对比里(Table 1),平均分是长上下文赢,GPT-4O 48.67 对 32.60;但作者的混合方案 Self-Route(先让 RAG 答,答不了再交给长上下文)在 GPT-4O 上只用 61% 的 token 就拿到 46.83 分,同口径长上下文是 47.04(§4.2)。另外有 63% 的查询,两种方式给出的答案完全一样。综述 §VII-A 也承认长上下文已经超过 200,000 token,RAG 留下的理由是速度、引用和可观测。
别把“多塞内容一定变差”当定律。综述 §VII-B 引用的研究发现,无关文档有时反而把准确率提高 30% 以上。召回调大会不会混进干扰,得看具体数据。
排查时就用同一道问题,把条款原文、切块、召回结果和最终提示排在一起。“须提供主办方书面日程”在哪一步消失,下一处该改的代码往往就在那里。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。