假想文档只管拿什么去查:HyDE 的完整成绩单、失败案例,以及后来的复测为什么不太乐观。
HyDE 先让模型写一段假想文档,再拿这段文字去查真实资料。不知道答案才需要检索,为什么中间先加一份可能写错的回答?
论文(正式版发在 ACL 2023,数值与预印本一致)要解决的是查询和文档的表达差异。用户的问题可能只是一句口语,相关文档却用更完整的术语和解释。先让模型写出“相关文档大概会怎么写”,给查询补上这些表达,再交给编码器生成向量,去真实语料的索引里找近邻。
草稿和检索结果并不一致
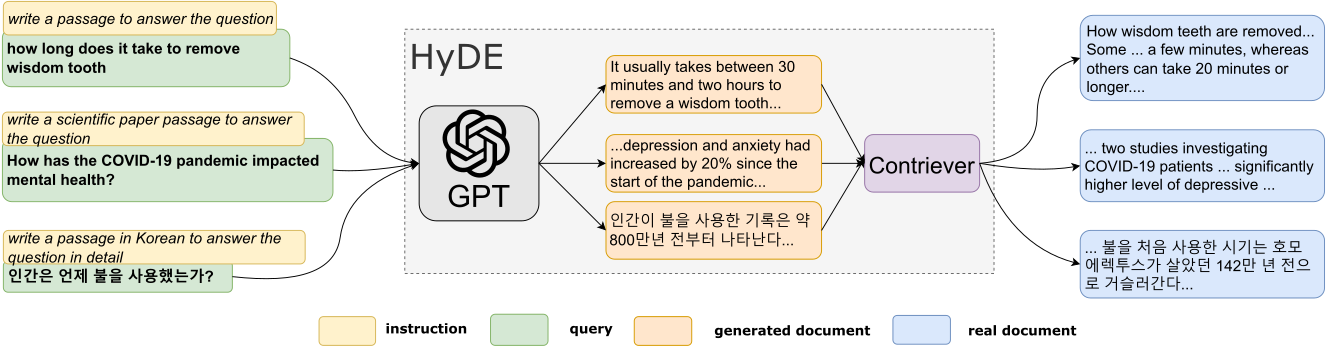
图源:论文 Figure 1,版权归原作者。
图里的问题是拔智齿要多久。假想文档写的是约 30 分钟到两小时;旁边检索回来的片段谈的是不同的拔除过程,有几分钟的,也有超过 20 分钟的。这些片段各适用什么情况,这里先不判断,但草稿和检索结果显然没有逐项对上。
草稿提供的是话题和词汇,真实文档才是接下来要读的材料。图里生成的数字不能直接搬进回答。
草稿只决定拿什么去查
这正是 HyDE 和“让模型补知识库”的区别。假想段落只用来形成查询表示,不作为可信文档加入索引,查回来的仍是原有语料。
所以语料里没有的内容,草稿写得再像也查不出来;草稿写错的地方要是没出现在召回片段里,那只是一次措辞尝试,不能当答案的依据。原方法还可以生成多篇再平均向量,也可以把原查询向量一起平均,减少单次措辞的影响。不过论文没给具体生成几篇;Haystack 的文档示例用的是 5 篇。
草稿的体裁也不是模型自由发挥。论文附录 A.1 给每个数据集配了一条固定指令,网页搜索那条是:
Please write a passage to answer the question Question: [QUESTION] Passage:
其他数据集有的要求写成新闻,有的写财经回答,有的写反方论证。指令定了体裁,也就定了草稿的词汇往哪边偏。
作者用稠密瓶颈来解释:编码器可能会过滤掉生成文本里的部分无关细节。这个解释和数字真假无关,编码器只是把一段文字压成向量,并没有逐条核对草稿。错误内容如果改变了主题表达,检索照样可能偏。原图把草稿和真实结果并排放,正好可以比较哪些词帮着找到了相关材料,哪些细节没有得到同样的支持。
草稿写歪会直接毁掉召回
LlamaIndex 的官方 HyDE 示例自己记了两个失败案例。一个是查询脱离上下文就被误解:问 “What is Bel?”,草稿写成了古代闪米特神祇,检索结果跟着全偏。另一个是开放式问题被草稿带偏。它提供 include_original 开关,让原查询和草稿一起参与检索,就是为了兜这种底。
ACL 2025 Findings 的一篇分析更进一步:在事实核查任务上,提升只出现在“生成文档里恰好有被金标准证据蕴含的句子”的样本上;没对上的样本,HyDE 反而低于 Contriever 基线(SciFact 50.8 对 55.1)。作者怀疑一部分增益来自模型预训练时见过基准里的知识。草稿写错不是无害的措辞尝试,它会把检索往错的方向拉。
nDCG 提升明显,但不是每个集都赢 BM25
实验用 text-davinci-003、温度 0.7 生成假想文本,英文检索用 Contriever,多语言用 mContriever(方法与实验设置)。nDCG@10 的几组数字:
| 数据集 | BM25 | Contriever | HyDE |
|---|---|---|---|
| TREC DL19 | 50.6 | 44.5 | 61.3 |
| TREC DL20 | 48.0 | 42.1 | 57.9 |
| TREC-COVID | 59.5 | — | 59.3 |
(DL19/DL20 出自论文 Table 1,TREC-COVID 出自 Table 2;“—”处这里不列。)
Table 1 还报了前 1000 条的召回:DL19 上 HyDE 88.0,BM25 75.0,Contriever 74.6,提升不只在排序上。
几点读法:
- 这是论文自己的结果。换生成模型、换编码器,或者换到自己的语料上,能提升多少都得重测。
- nDCG@10 看的是前十条的相关性和排序,不是最终问答的正确率。
- “无需相关性标注”指的是不用目标任务的查询与相关文档配对来训练,不是模型从没训练过。
- DL19 上 BM25 比单独的 Contriever 高;TREC-COVID 上 HyDE 和 BM25 几乎打平,它没有在每个测试集上都超过关键词检索。
“几乎打平”只说的是 nDCG@10,差 0.2,作者自己点明了。同一张 Table 2 里 TREC-COVID 的 recall@100,HyDE 41.4、BM25 49.8,召回上关键词检索还领先 8 个点。多语言的 Mr.TyDi(Table 3,MRR@100)也一样有输有赢:
| 语言 | BM25 | HyDE |
|---|---|---|
| 斯瓦希里语 | 38.9 | 41.7 |
| 韩语 | 28.5 | 30.6 |
| 日语 | 21.2 | 30.7 |
| 孟加拉语 | 41.8 | 41.3 |
生成模型的影响更大。§5.1 的 Table 4 在 DL19 上换了三个生成模型:Flan-T5-11b 48.9,Cohere-52b 53.8,text-davinci-003 61.3,最强和最弱差了 12 个点以上。论文还划了一条边界:编码器已经微调过时,HyDE “不是预期用法”。它是给无监督编码器补表达的。
论文也没交代的几件事:生成几篇来平均、每次查询多花多少延迟和 token,都没有数字,也没做显著性检验。
所以我觉得,试 HyDE 之前,先把现有关键词检索的结果摆在旁边更有用。换一种查询表达能改善一部分问题,具体任务值不值得多一次生成,直接比较召回结果就知道。
后来的复测也提醒别预设它有用。EACL 2026 的一篇在 PopQA 上测,HyDE 让 ModernBERT 在原始查询上的 R@5 掉了 5.43%,只在错字、口语化这类表述变体上平均提升 2.61%。同类的 Query2doc 换了个思路:不用伪文档替换查询,而是拼在原查询后面,稀疏检索时还把原查询重复 5 次来压住伪文档的权重。我倾向于这种拼接式做法,原查询始终在场,草稿只能加词,夺不了主导。
接进问答程序,草稿和证据分开存
查询草稿和证据列表最好放在不同字段。作者实现 里生成、编码、检索各是一步,我们也可以照着把材料来源分开。LangChain 的 HyDE 实现直接把论文附录的八条模板写进代码,流程就是“生成假想文档,再 embed”,说白了就是一次查询改写调用。这样最后生成答案时读的是召回原文,那份假想文档不会因为已经在上下文里,就被顺手当成另一个来源。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。