沿 AFlow 搜出的 MBPP 工作流走一遍:修复稿直接返回,没有再测。
AFlow 论文附录给了一份用于 MBPP 的搜索结果,流程不复杂:生成三个代码候选,选一个,拿去测试,失败了再修。这比“模型自动优化工作流”好懂多了,也能直接检查它到底优化出了什么。
修复稿绕过了最后一次测试
按附录 B.1 中的执行顺序整理,省略了具体类名和提示参数:
依次生成代码候选 1、2、3将三个候选交给 ensemble 选择测试选中的代码 测试成功 → 返回测试后的 solution 测试失败 → 把题目、失败代码和错误交给模型修复 → 返回修复稿图里的“错误”要打个折扣:按附录 A.4 和 B.1,Test 算子几轮修复后仍失败时返回的是最后一版代码,B.1 把它放进名为 Error: 的字段交给修复,传过去的并不是实际的测试报错。
三个候选是在 for 循环里逐个 await 的,三次生成没有同时跑,耗时按顺序相加。
同一节还有一份 AlphaCodium 风格的 MBPP 变体:选出候选后,先让模型按题目和候选再写 3–5 条断言,拼成 enhanced_problem,再交给测试。上面这份最优流程没有这一步。
选择那一步的实现也得说清。仓库里的 ScEnsemble 不是多数投票:它把候选标成 A、B、C,让模型回一个 solution_letter,按字母取回对应代码。一次调用定胜负,不跑代码,选错也就选错了。同一个文件里另有 MdEnsemble,默认投 5 次、每次打乱候选顺序,那才是真投票,这份工作流没用它。
测试节点也不是一次断言。Test 的签名是 test_loop: int = 3:先拿公开测试跑,失败就把错误喂给反思提示改一版,最多三轮,结束后再跑一次定结果。按附录 A.4,MBPP 这类数据集拿每题的第一条测试当公开测试。
更容易看漏的是末尾:失败后的修复稿直接返回,没有再经过上面的测试。修复提示确实要求保持函数名与签名、针对错误修改,但模型交出修复稿和测试确认修好之间,还少一步。到了评测里,这份修复稿算不算通过,要看评测代码自己有没有再跑一遍。
图上有 Test,听着像最后的答案已经测过;沿实际返回路径走一遍,会发现有一条路径绕过了最后一次测试。用到自己的代码里,要先决定修复后是否再跑测试、失败允许重试几次,不能把“有测试节点”当成整个输出的性质。
评测那一端会重跑
旧问题的另一半,仓库里有答案。benchmarks/mbpp.py 拿到工作流最终返回的代码后,会用数据集自带的 test 再跑一遍,通过记 1.0,否则 0.0。
所以修复稿没修好,不会白拿分。漏掉的是工作流自己的最后一次检查:它不知道这份修复稿好坏,也就没法在内部再修一轮。放到线上没有评测器兜底的场景,这一步就得自己补。
论文对这份流程的评价也挺直白。附录 B.1 说它只是把算子和一个巧妙的 FIX-CODE 提示组合起来,“虽然简单,分数很高也很稳”。搜出来最好的东西,不一定复杂。
搜索树上,一个节点是一整份工作流
按附录 B.1,这份 MBPP 流程是在搜索第十四轮找到的。AFlow 先给一组可调用的 Operators,例如代码生成、评审修订、测试和集成,再让优化器修改连接这些操作的代码与提示。
附录 A.4 列了全部六种:Generate(分 Contextual 和 Code)、Format、Review & Revise、Ensemble、Test、Programmer,各自绑着固定提示。
这些算子不是必需的。§5.2 的消融里,GSM8K 上一个算子都不给,AFlow 仍拿到 93.1%,超过所有手写工作流,还自己长出了类似 ensemble 的结构。算子的作用是让搜索更快找到好结构,不是全靠这套提示模板撑着。
一份完整工作流才是搜索树中的一个节点。节点被选中后生成下一份候选,跑验证题,把它比上一份好在哪、差在哪记下来,供后续继续改。
下一轮改谁,也不是贪心挑第一名。按 §4 和附录 A.6 的算法,优化器从分数靠前的几份和初始工作流里抽一个当父节点,概率是均匀分布和分数 softmax 的混合,所以差一点的候选也有机会被继续改。前几名的平均分连续若干轮不涨就早停(仓库代码默认看前 3 名、连续 5 轮),20 轮只是上限。
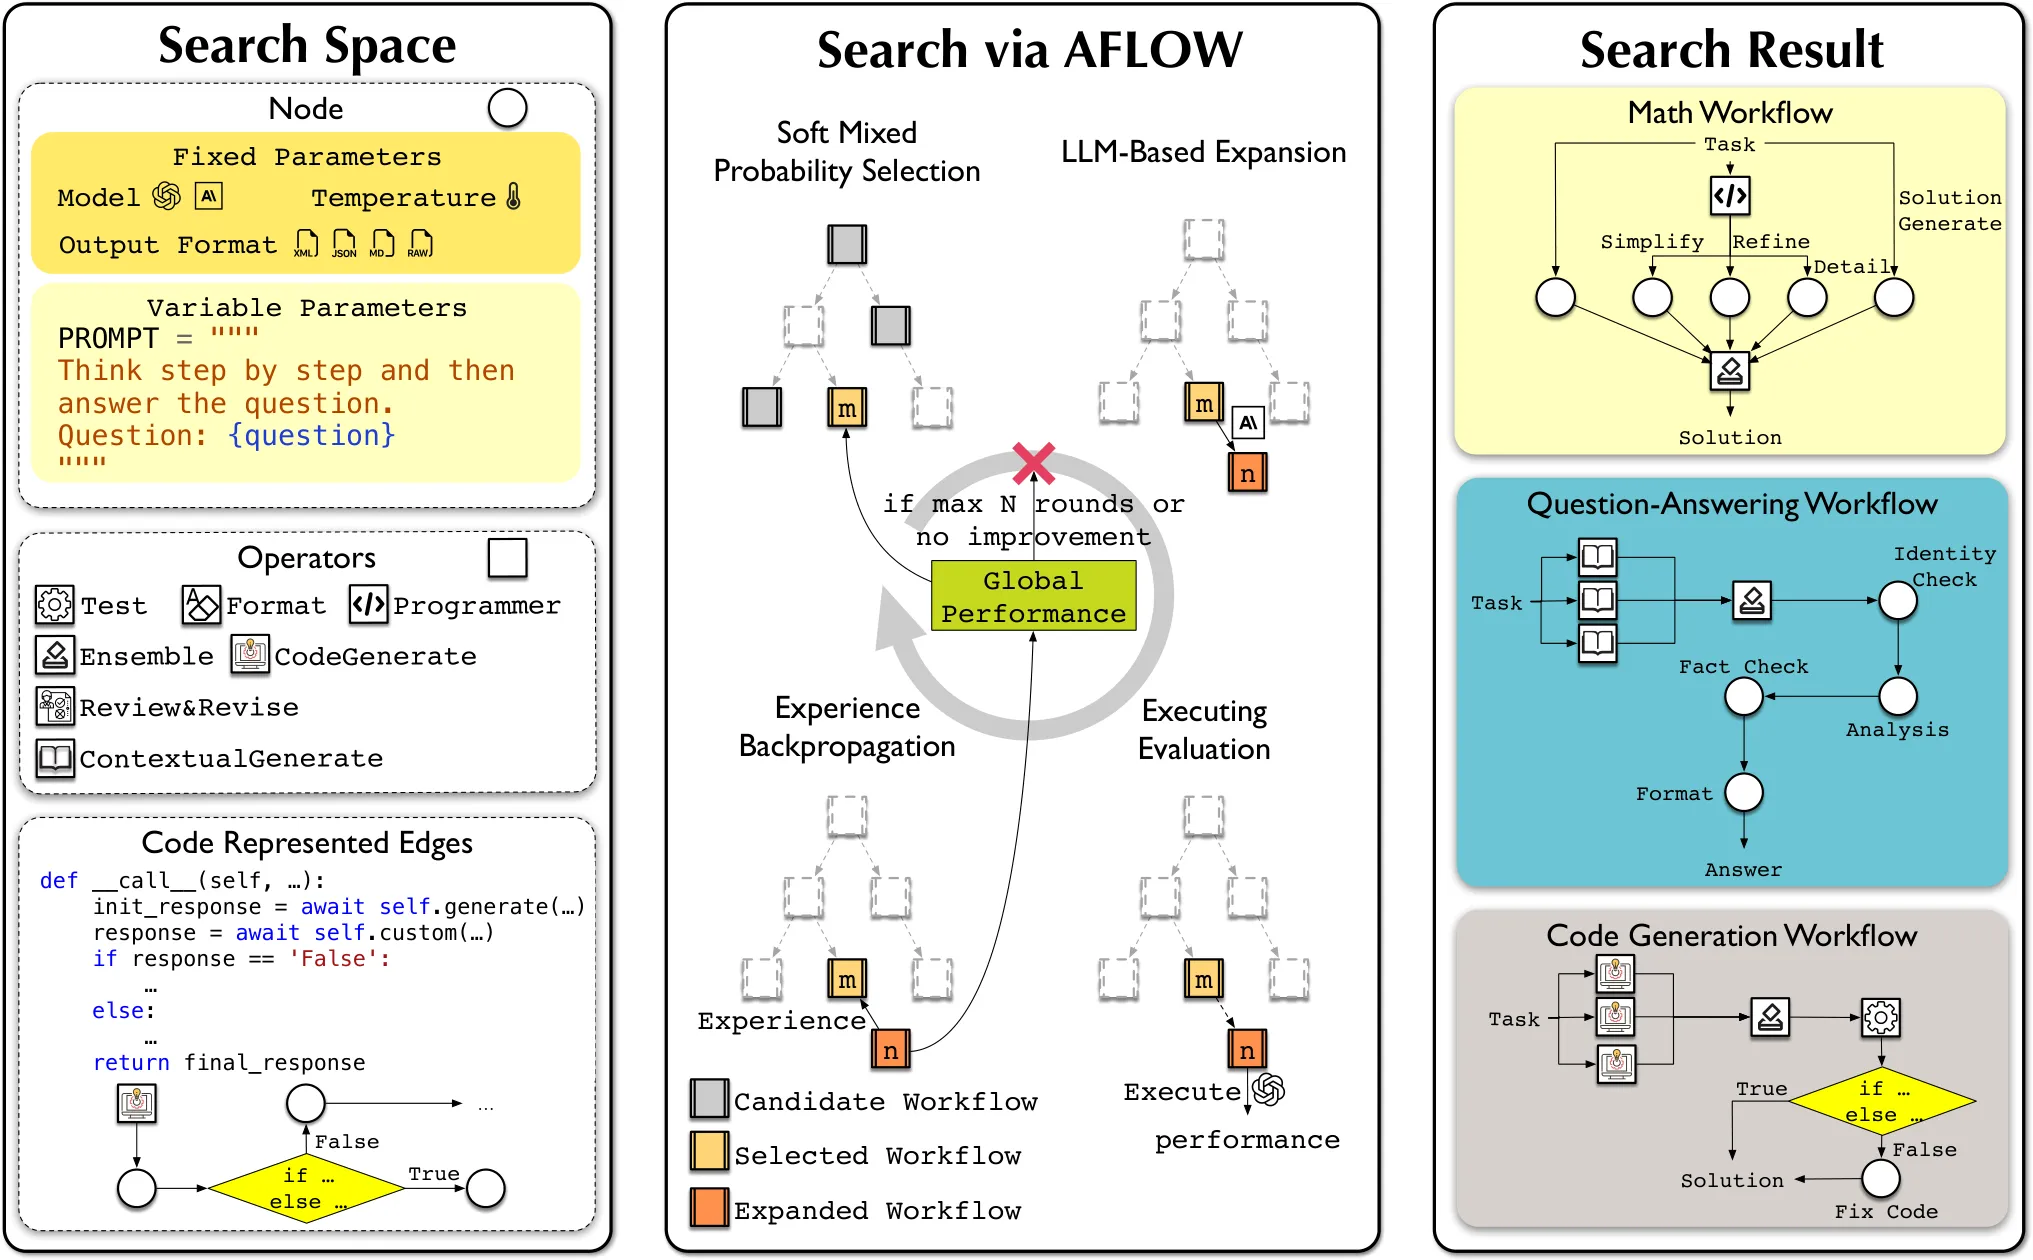
图源:论文 Figure 3,版权归原作者。这棵树是在找解题程序,并非在一道题内搜索几个中间答案。
外层不是看一次顺眼就留下
论文的表示能描述模型、温度、输出格式等属性,但实验主要改的是提示和连接代码,模型等设置固定。能调的字段和真调过的不是一回事;论文也没说运行差异全由这两样造成。
搜索设置:
- 优化器用 Claude 3.5 Sonnet,主实验执行器用 GPT-4o-mini,搜索 20 轮;
- 数据按 1:4 分成验证和测试,测试部分不参与搜索打分;
- 先在验证部分跑空模板五次,挑波动较大的题做搜索验证集;
- 新候选也重复跑五次,比较均值和波动。
跑五次是为了降低单次波动的影响,单次起伏还会不会左右结果,文中没有保证。但至少,外层不是看一次回答顺眼就把流程留下。
模型固定这件事,论文也专门测过另一面。表 2 把同一份在 HumanEval 上搜出的工作流换到别的执行模型:DeepSeek-V2.5 是 93.9,Claude-3.5-sonnet 是 95.4,GPT-4o 是 96.2,都还领先手写基线。不过论文同时承认,不同模型要各自的工作流才能到最优。迁移得动,和换了模型还是最优解,是两回事。
80.3 对 76.0,平均分要拆开看
六项主任务里,AFlow 平均 80.3,人工 CoT Self-Consistency 是 76.0,差 4.3 个点。摘要写的约 5.7% 是相对提升,4.3 除以 76.0 差不多就是这个比例。
这个平均混了数学正确率、问答 F1 和代码 pass@1。想判断自己的代码任务合不合适,得回到对应那一列,不能只读平均。实验结果
拆开以后差距很不均匀(表 1,执行器 GPT-4o-mini):
| 任务 | AFlow | CoT SC | 差 |
|---|---|---|---|
| MBPP | 83.4 | 73.6 | 9.8 |
| MATH | 56.2 | 50.4 | 5.8 |
| HumanEval | 94.7 | 91.6 | 3.1 |
| DROP | 80.6 | 78.8 | 1.8 |
| 六项平均 | 80.3 | 76.0 | 4.3 |
代码和数学拉开了平均,问答几乎没动。如果你的任务像 DROP,这套搜索未必值那份开销。
开销本身也要看口径。摘要里那句“4.55% 的推理成本”,按附录 D,说的是用更便宜的执行模型跑 HumanEval 测试集、按 token 算钱,跟 GPT-4o 比。20 轮搜索、每个候选在验证集跑五次的花费,不在这条线上。
后来的人在改哪两处
我觉得 AFlow 留下的两个软肋,后来的工作都在打。
- 算子从哪来。A²Flow(AAAI 2026)嫌算子靠人手预定义、难泛化,改成从专家示范里自动抽算子。
- 分数从哪来。AFlow 的反馈就是“这份工作流在验证集上多少分”,好坏压成一个数。JudgeFlow 加了一个读执行轨迹的 Judge,给每个逻辑块算责任,让优化器只改最差的那块。
回到 MBPP 这份流程,后一个方向最对症:一个总分告诉不了你“修复稿没再测”这种缺口在哪。
代码这边是反方向走的:算子最早写在 MetaGPT 里,后来迁到 AFlow 独立仓库,README 自己提醒“Some Operators may have bugs during the migration from MetaGPT to this repository”。照着跑之前,值得先对一下算子代码。
官方仓库的 README 提供各轮实验包。只打开仓库里 round_1 的初始文件,看到的还不是论文找到的最终工作流。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。