LATS 的 value 进选路公式前被多除了一次;这个写法在官方仓库没修,还被搬进了 LangGraph 教程。
LATS 把模型试过的动作放进搜索树,下一步选哪条路,就得给节点一个能比较的值。读到回传那部分我停了一下:这里叫 backpropagation,更新的是树上的访问次数和搜索值,没有对语言模型做梯度训练。
这篇是 ICML 2024 的论文(arXiv 摘要页,2023 年 10 月投出 v1,2024 年 6 月改到 v3)。我顺着 value 这个字段,从论文公式一路追到官方代码,又追到 LangGraph 的教程,发现它在每一处的含义都不太一样。
选路靠两项:回报和探索
论文的选路公式把节点期望回报与探索项相加。表现不错的分支值得再试,访问很少的分支也留些机会。动作执行后拿到环境反馈,结果沿父节点往回更新。文字反思另外保存失败经验,后面生成候选时能读到。
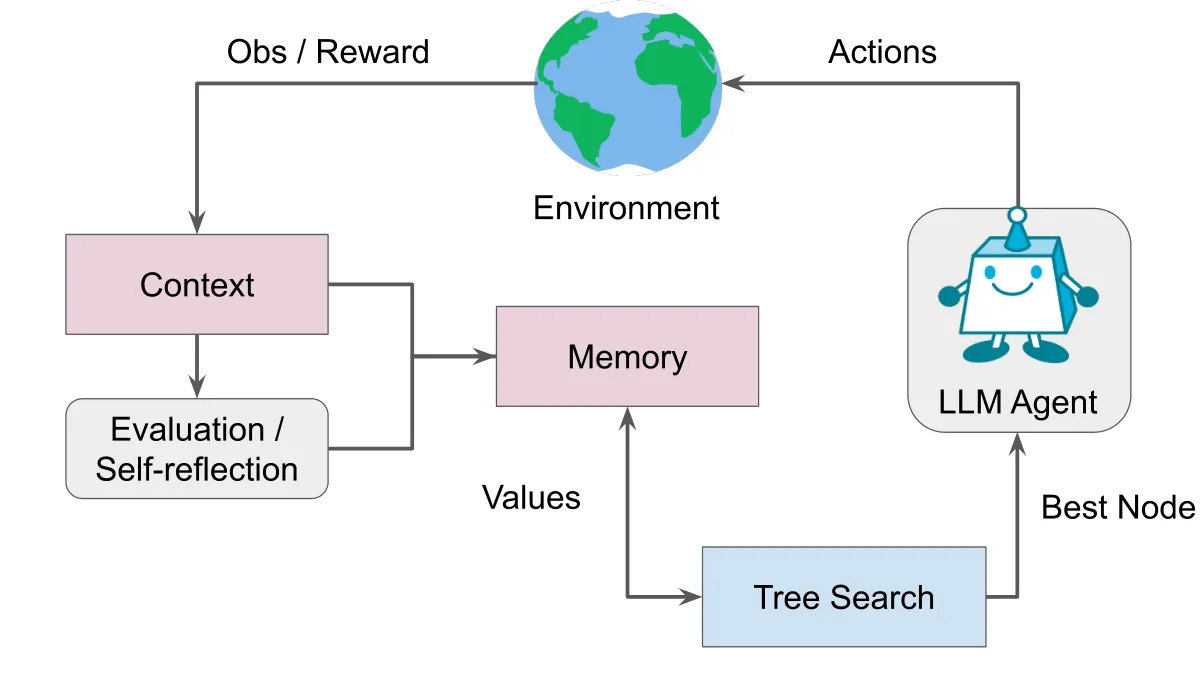
图源:论文 Figure 1,版权归原作者。回传更新树的统计量,图里的反思记忆保存文本,两条路径都参与后续尝试。
写成公式就是论文 §3.2 的式 (1):UCT(s) = V(s) + w · sqrt(ln N(p) / N(s))。V(s) 是从这个节点出发的期望回报,w 是探索权重(论文里叫 w,不是常见的 c),N 是访问次数。§4.2 的回传把 V 写成滑动均值:V(s_i) = [V(s_{i−1}) · N(s_{i−1}) + r] / N(s_i)。所以论文层面只归一化一次,回传写进去的就是均值,选路直接拿来用。
V 的初值来自价值函数,论文式 (2) 把它定义成模型打分和自洽性打分的加权和:V(s) = λ·LM(s) + (1 − λ)·SC(s),λ 在 HotPotQA 取 0.5,编程和 WebShop 取 0.8(论文附录 A)。
去掉价值函数,掉分最多
我较真这个字段,是因为论文自己的消融说明它最要紧。HotPotQA 上的对比(论文表 8,§5.4):
| 变体 | 成绩 |
|---|---|
| LATS(完整) | 0.63 |
| 去掉反思 | 0.58 |
| 换成 DFS 搜索 | 0.42 |
| 去掉 LM 价值函数 | 0.37 |
去掉价值函数,成绩掉 0.26,比去掉反思、换掉搜索策略都狠。探索权重也敏感:默认 w=1,消融里 w=0.5 掉到 0.55,w=2.0 是 0.63(附录 A、表 11)。
树搜索也不见得更贵。论文表 9 统计成功时的 token 消耗,LATS 是 173,290,ToT 210,215,RAP 176,500,LATS 反而最少,展开的节点也更少。
均值已经算过一次了
用一个自拟的小例子看回传:某节点访问了两次,当前均值 0.5,这次得到 1。新均值是 (0.5 * 2 + 1) / 3,约 0.667。先把旧均值还原成累计量,加上新结果,再除以新次数。
官方仓库这一固定版本的 HotPotQA 实现里,backpropagate 的普通分支做的正是这个更新:
node.value = (node.value * (node.visits - 1) + value) / node.visits这里 visits 先自增,再用新次数算均值,和论文一致。还有一个失败分支:终局且奖励为 0 时,代码写进去的是 −1 而不是 0,把走到死胡同的路往下压。
可往前找 uct(),利用项写成了 self.value / self.visits,后面才加探索项。回传后的 0.667 进到这里,会再除以 3,变成约 0.222。顺带两个细节:探索常数硬编码成 √2,没有参数可调;visits 为 0 的新节点直接返回 self.value,不走这个公式。
这次额外的除法意味着什么
把 value 固定成同一个正数再比 visits,利用项会随 visits 增大而变小:
| 节点访问次数 | value | 利用项 |
|---|---|---|
| 1 | 0.667 | 0.667 |
| 3 | 0.667 | 约 0.222 |
这是照这两行代码算的算术,不是实测的选路结果。实际跑起来 value 每轮都被回传改写,两个量一起变,不能说某条路的利用项会一路递减。
论文式 (1) 直接用期望回报 V,没有这次额外的除法。标准 UCT 的利用项是平均胜率 w_i/n_i,分子是累计胜场(维基百科 MCTS 条目),只有分子是累计量时,除以访问次数才对。这一处不能直接当成标准 UCT 的实现来用。
同一个字段,三种约定
evaluate_node 还会给 child.value 赋模型评估值,所以这个字段不总是累计奖励的均值。三种约定并存:
- 回传按均值写入;
- 评估按模型给分写入;
- 选路按累计和读出。
评估那一步写的是模型票数本身(child.value = votes[i])。旁边有一段把票数除以最大票数、再给终局节点加成的代码被注释掉了,看得出这个字段的语义改过不止一次。论文式 (2) 里的自洽性项 SC,我在这份 hotpot 代码里没找到对应实现。
读这段代码,得先分清手上这个值是谁写进去的。我能确认的是,这个版本的回传和选路公式放在一起,和论文描述有差别。我没跑对照实验,推算不了成绩受了多少影响,也不把这个观察扩到仓库里的所有任务。
不扩是对的,同一个仓库里就有反例。programming/mcts.py 的 update() 写的是 self.value += reward,存累计和,在那里除以 visits 才正好是平均回报。所以单看哪一行都不算写错,毛病出在 value 的约定随文件变了,hotpot 这份恰好把均值当成了累计和。
这个写法还在,而且被搬走了
到今天,上游 master 的 hotpot/lats.py 里 uct() 那一行仍和我引的固定版本一字不差。
别人也撞到过相邻的问题。issue #33(2024 年 8 月)问 evaluate_node 为什么把 Lookup 动作的评估值赋给了 Finish 节点,以及 λ 和自洽性奖励在代码哪里;issue #36(2025 年 10 月)指出论文伪代码把扩展、模拟、选择放在同一轮,代码却拆成三步。两个 issue 都还开着,没有维护者回复。
论文自己也不完全对得上。附录 A 的 Algorithm 1 里,选路分母用的是子节点访问数 N(s_{t+1}),和正文式 (1) 的写法不同;HotPotQA 的最大深度,附录 C 说 7,附录 D.1 说 6。所以读代码时,我不会默认论文那边就是自洽的标准答案。
更值得注意的是 LangGraph 的 LATS 教程。它的 upper_confidence_bound 也写 average_reward = self.value / self.visits,backpropagate 写入的同样是均值,探索权重默认 1.0。照着教程搭 LATS 的人,大概率把这次额外的除法一起抄走了。
拿一棵小树先手算
我会先用一棵很小的树检查实现:每次更新后打印 visits 和 value,手算下一次的利用项,再看程序选了哪个孩子。
这样至少能分清,某个节点受青睐是因为模型给分高、后续回报好,还是访问次数又参与了一次归一化。如果是自己从教程改出来的 LATS,我会先定死 value 存均值还是累计和,再让 uct() 和 backpropagate 按同一个约定读写。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。