拆一份 ADAS 搜出的候选程序:Verifier 的结论,其实没人用。
给三个模型调用分别取名 Teacher、Student 和 Verifier,听起来已经像一套解题方法。可把名字遮住,只看输入输出,程序到底多做了什么?
ADAS 的结果档案里刚好有一份能拆开的候选,叫 Dynamic Role-Playing Architecture,是 MGSM 搜索第 4 代的设计。
五次调用,第二轮照跑不误
这份官方存档的 code 字段存着完整的 forward。按实际传值缩写成阅读用的伪代码:
解释 = Teacher(题目)思考, 答案 = Student(题目, 解释)结论, 教师反馈, 学生反馈 = Verifier(题目, 思考, 答案)新解释 = Teacher(题目, 教师反馈)新思考, 新答案 = Student(题目, 新解释, 学生反馈)返回新答案分工不难懂:教师先给解释,学生据此作答,验证者分别给教师和学生反馈,然后再来一轮。
让我停下来的是第三行。Verifier 返回的结论没有被用来决定是否继续。哪怕它认为原答案没问题,程序也照样再调一次教师和学生,交出第二份答案。
这和“答错了才修”不一样。角色叫 Verifier,代码里却没有验证通过就放行的分支。只用自然语言概括成“教师指导、学生回答、验证者检查”,会把这个执行细节整个漏掉。
名字是 meta agent 现起的
再往前推一步:Dynamic Role-Playing Architecture 这个名字本身也不是人起的。论文附录 B 的提示词要求 meta agent 给修改后的架构起个名,只特别交代别在名字里写 “new” 或 “improved”;同一份提示词还在喊 “THINK OUTSIDE THE BOX”,让它从相关的 agent 论文里找灵感。算法 1 里另有两轮自反思,用来“保证新颖和正确”。论文附录 B 与算法 1
所以表里那些名字是搜索的产物,说明不了设计。名字说“角色扮演”,程序里有没有角色在起作用,得一行行看传值。
有人在公开评审里提过同样的怀疑。ARC 上胜出的设计让 GPT-3.5 分别扮演效率专家、可读性专家、简洁专家,可 ARC 只看输出对不对。那篇评审的原话是:
Efficiency and readability are irrelevant.
他追问这些角色是承重的还是装饰性的,作者为什么不做消融。Review: Automated Design of Agentic Systems 这里拆的 Verifier 是同一类问题:名字像分工,结论没人接。
角色名不会替程序建一份共享记录
第二轮里各方能读到的东西:
- 教师拿到题目和教师反馈,没有直接拿到自己的旧解释;
- 学生拿到题目、新解释和学生反馈,没有直接拿到旧答案;
- Verifier 也没直接收到教师的解释,只能依据学生的思考和答案等输入写教师反馈。
Verifier 能影响后续的只有它生成的反馈,它自己的结论没被后面接走。反馈可能带着相关信息,但带了多少,要看它实际写了什么。给角色取了名字,不会替程序建一份共享聊天记录,传了哪些对象就只能读哪些材料。
两层修改:修答案和修程序
框架源码用 Info 保存内容、作者和迭代编号等信息,再展开成提示,候选的工作就是安排这些基础调用。ADAS 搜的正是这种 forward 程序:外层模型写它,跑一批题,记录结果,再改出另一份。
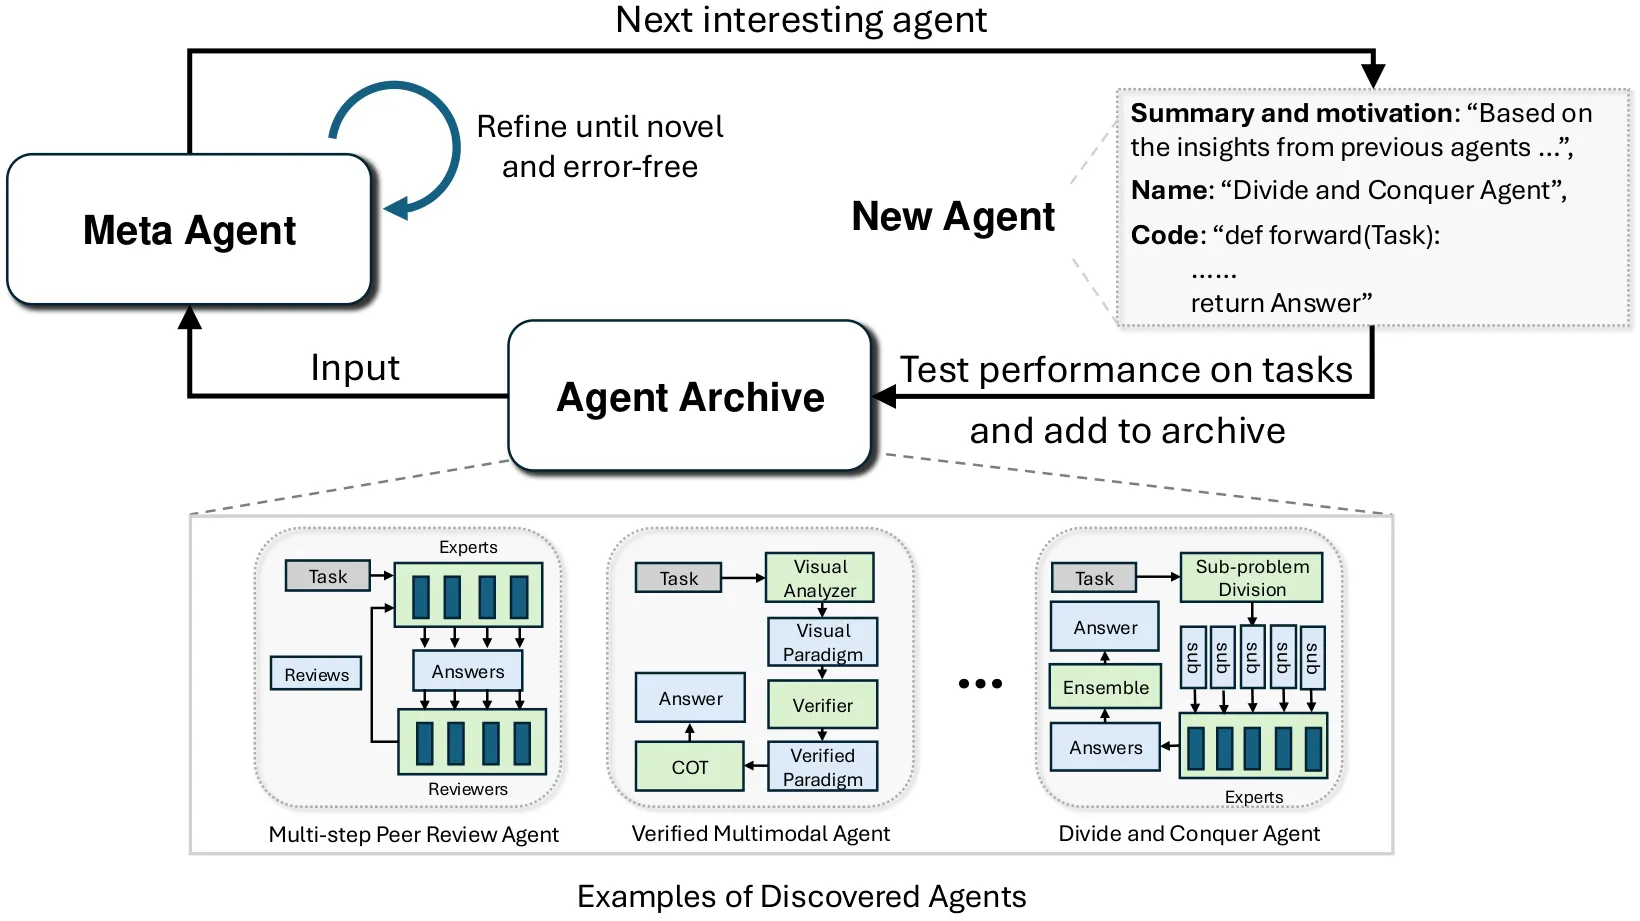
图源:论文 Figure 1,版权归原作者。图中一个候选可以是上面整套五次调用的程序。
所以这里有两层修改:
- 候选内部的教师和学生,修的是某一道题的答案;
- 外层 meta-agent 根据多道题的表现,改调用方式、提示和控制逻辑。
候选代码执行报错时,搜索框架也会把异常交回外层修代码,这同样不是 Verifier 在批改答案。
53.4% 就是这份候选的成绩
论文在 MGSM、DROP、MMLU、GPQA 等领域分别搜索,外层用 GPT-4,候选与人工基线用 GPT-3.5,搜索 30 轮。MGSM 上:
| 设计 | 准确率 |
|---|---|
| 最佳人工基线 | 39.0% |
| 最佳搜索设计 | 53.4% |
53.4% 是整场搜索里最好的设计,按结果存档,它正是这里拆的第 4 代 Dynamic Role-Playing Architecture,论文表里也把它列为第一。迁移实验有挑前三个候选的步骤:ARC 迁到其他模型时写明按测试准确率筛,MGSM 迁到其他域没写筛选依据,读表时要连着这个筛选过程看。实验与搜索分析
论文后来出了 v2,也就是 ICLR 2025 的版本。在 v2 的表 1 里,这两个数字都带区间:Meta Agent Search 是 53.4±3.5,最佳人工基线是 LLM Debate 的 39.0±3.4,写法是“中位数 ± 95% bootstrap 区间”。
题量、跑几遍、花多少钱
读这类数字前,我会先看它背后有多少题。按 v2 的 §4 和附录 D、E:
| 项目 | 设置 |
|---|---|
| 搜索轮数 | ARC 25 轮,其余域 30 轮 |
| 外层 meta agent | gpt-4o-2024-05-13 |
| 候选与基线 | gpt-3.5-turbo-0125 |
| ARC 验证/测试 | 20/60 题,各跑五遍 |
| 其余域验证/测试 | 128/800 题;只有 GPQA 跑五遍,其他跑一遍 |
验证集只有 128 题,搜索 30 轮都靠它挑方向,最后再上 800 题测试。
钱也不少。附录 J 给出的 OpenAI API 花费:ARC 一次约 500 美元,其余域约 300 美元,大头花在评估时反复调 GPT-3.5。论文自己也承认这个评估函数又贵又丢信息。
从零开始,数学反而更好
论文唯一的消融在附录 I 表 6:把人工基线作为种子放进档案,和什么都不放直接搜。
| 域 | 有初始设计 | 不初始化 |
|---|---|---|
| 阅读(DROP F1) | 79.4 | 73.9 |
| 数学(MGSM) | 53.4 | 67.5 |
| 多任务(MMLU) | 69.6 | 68.5 |
| 科学(GPQA) | 34.6 | 32.7 |
不初始化在四个域仍然打赢人工基线。有意思的是数学:从零开始反而高出十几个点。53.4 这个最常被引的数,在论文自己的消融里并不是数学域的上限。
先数调用,再看哪些返回值被用掉
读这种自动生成的流程,我会先数实际调用,再看哪些返回值被用掉。上面的 final_verdict 就是个好入口:想让通过的答案直接返回,得在这里加分支,再重新比较结果和花费。
加这个分支也不一定更好。Large Language Models Cannot Self-Correct Reasoning Yet(ICLR 2024)的结论是,没有外部反馈时,模型自己检查再改不能稳定提升推理,有时反而更差。Verifier 和学生用的是同一个 GPT-3.5,它说“通过”有多可信,本身就得测。
改过之后就是另一份程序,搜出来的分数和花费不能沿用,要重新评测再比。按附录 J 的价位,这不是重跑一道题的事。
这份程序并不特殊
拆到底,这份候选就是今天文档里常见的 evaluator-optimizer 模式。Anthropic 的 Building effective agents 把它定义为一次调用生成、另一次调用评价并反馈,循环往复;适用条件是评价标准清楚、迭代确实带来可测的提升。文档还建议给自主循环设停止条件,比如最大迭代次数。
对照一下,ADAS 搜出来的程序缺的正好是那个“什么时候停”。它不看 Verifier 的结论,固定跑两轮。
这条线后来也在变。AFlow 把工作流优化写成对代码表示的工作流做搜索,用蒙特卡洛树搜索加执行反馈;SwarmAgentic(EMNLP 2025)用粒子群的思路做全自动系统生成。共同点是把搜索变得更结构化,不再全靠 meta agent 自由发挥。
我的判断是,ADAS 留下的最有用的东西是“agent 就是一段可以改的 forward”这个表示,具体哪个候选倒在其次。至于搜出来的某一份程序,照样得先数调用、看返回值去哪了。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。