用官方海沟示例画出依赖:规划和调度各省掉哪一段等待。
比较两组海沟的绝对深度差,再取较小的差值,一共要查四个地方。查完马里亚纳海沟才能查波多黎各海沟吗?这两次搜索之间没有依赖,要等它们都回来才能做的,是后面的减法。
先画出依赖:1、2、4、5 可以一起发
LLMCompiler 官方 ParallelQA 提示里就有这个例子。Planner 把工作拆成下面的计划,数字是任务编号,后面的计算引用前面的结果。这里按原示例重新整理,不是一次实测运行:
1 查询 Mariana Trench2 查询 Puerto Rico Trench3 计算绝对深度差,依赖 1、24 查询 South Sandwich Trench5 查询 Sunda Trench6 计算绝对深度差,依赖 4、57 取较小差值,依赖 3、68 join,汇总结果官方提示里,3 写成 math('absolute depth difference between Mariana and Puerto Rico Trench in meters?', ['$1', '$2']),7 是 math('min($3, $6)');配套输出提示里两个差值是 2608 和 912,答案落在 912 米。
1、2、4、5 可以先发出去。哪组先回来,哪组的差值先算,3 不用等 4、5;只有 7 要同时等两个差值。程序要管的主要是“依赖齐了没有”,没必要每次工具返回都再请模型确认一句“现在可以做减法”。
模型写计划,程序管执行
职责拆成三块:
- Planner:写计划,用
$1等引用尚未返回的结果; - Task Fetching Unit:检查依赖是否就绪;
- Executor:调用工具。
就绪看的是编号:3 依赖 1 和 2,两个都回来才轮到它。结果跟编号对上,后面的减法才知道拿哪两条深度。这一步只看引用到齐没有,不判断拿回来的内容对不对。
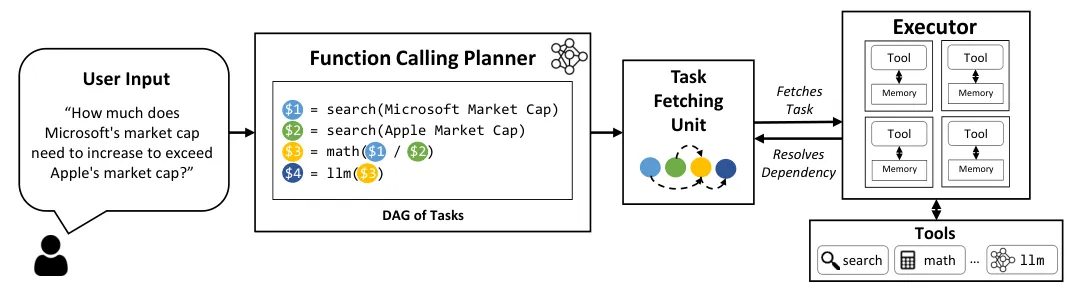
图源:论文 Figure 2,版权归原作者。
计划没写完,也能先动手
还有一段等待在规划本身。论文允许计划流式输出,第一个工具调用写完整就能启动,Planner 同时接着写后面的任务。查询和规划因此重叠,不必等整张图写完才执行第一步。四路查询一起发,和计划没写完就先动手,省的不是同一段等待。
不过流式规划省得不多。附录 C.1 的 Table C.1 做了开关对比:HotpotQA 从 4.00 秒到 3.95 秒,电影从 5.64 秒到 5.47 秒,几乎没差;只有任务多的 ParallelQA 从 21.72 秒降到 16.69 秒,约 1.3 倍。计划短的时候,边写边跑没多少可以重叠。
如果问题里有条件分支,比如先比较结果,再查较深那一处的其他资料,后续目标得等结果出来才知道。框架保留了动态重规划,把中间结果交回 Planner 继续产生任务。引用解决的是已知的计算依赖,重规划处理收到信息后才产生的新决定,不能为了并行把未知条件提前猜好。
省下的主要是等待,准确率另说
论文用 GPT-3.5-turbo 1106 做了一组比较:HotpotQA 比较题约 1500 道,有两路独立工作;电影推荐 500 个样本,可展开的独立工作更多。下面的数出自论文,我没有复现:
| 任务 | ReAct 延迟 | LLMCompiler 延迟 | 两者准确率 |
|---|---|---|---|
| HotpotQA 比较题 | 7.12 秒 | 3.95 秒 | 62.47% / 62.00% |
| 电影推荐 | 20.47 秒 | 5.47 秒 | 72.47% / 77.13% |
表 1 里其实还有第三方:OpenAI 的并行函数调用,HotpotQA 62.05%、4.42 秒,电影 77.00%、7.42 秒。HotpotQA 上它的准确率比 LLMCompiler 还略高,LLMCompiler 赢的是延迟。论文 §5.2 的解释是,OpenAI 只并行眼下能并行的调用,不看整张依赖图,遇到多层依赖要多次往返模型;LLMCompiler 一次把图写完,规划用的 few-shot 里也只有计划、没有 observation,提示更短。
表 1 里的 ReAct 是作者补过提示、减少了重复调用与提前停止的版本。比较题主要少了等待,准确率没提高;电影任务独立工作更多,加速更明显。原版 ReAct 干脆没测延迟,表注说循环和提前停止让延迟测不准,这本身就说明问题。
电影任务的准确率为什么涨了,§5.1 和附录 A 给了原因:ReAct 在约 85% 的样本上提前停止,LLMCompiler 有 99% 把 8 部电影都查完了。换成开源的 LLaMA-2 70B,准确率提升更明显:HotpotQA 从 54.40 到 57.83,电影从 70.60 到 77.80(表 1)。弱一些的模型更容易重复调用、提前收手,一次写好计划顺带把这些毛病也治了。
钱也省了。Table 2 按每 1k 次估成本:HotpotQA 上 ReAct 5.00 美元、LLMCompiler 1.47 美元;电影上 20.46 美元对 3.04 美元。计划只写一次,不用每一步都带着全部历史和模型往返。
附录 E.1 还拆了加速的上限:电影任务里规划开销 1.88 秒、回答 1.62 秒,搜索平均 0.61 秒,但最慢那次要 1.13 秒。一批并行查询要等最慢的那一路,规划本身的开销也省不掉。拿这些结果估自己的任务,先数依赖,比先记最大加速倍数更有用。
调度对了,计划也可能写错
自己画计划时,可以沿海沟例子逐个查引用。3 应该读 1、2,要是误写成 1、4,工具可能全都成功,结果却成了另一组差值。调度只保证条件就绪时运行,计划里的对象和计算关系还得自己核对。
不过论文的失败分析(附录 B,ParallelQA)里,Planner 只占失败的 8%,执行器占 64%,最终输出占 28%。实测中更常出事的是执行器查错属性、单位换算没处理好。我仍然会先核对计划,因为计划错了一切都错,而且最便宜查;但执行器那一侧同样值得盯。
依赖图只管数据,不管副作用
这张图只表达“谁要用谁的结果”。后续工作 LLMOrch 拿 LLMCompiler 当基线,批评它不考虑调用之间的互斥关系,也不考虑计算资源够不够。在计算密集的 KITTI* 上,LLMCompiler 用了 278.68 秒,LLMOrch 用了 143.19 秒(Table II);在 HotpotQA、电影这类 I/O 型任务上,两者差不多。
今天各家 API 已经默认支持一轮发多个调用。Claude 文档说模型可以在一次回复里给多个 tool_use,API 不规定执行顺序,有副作用、共享状态或有顺序要求的工具建议串行执行;OpenAI 文档也写着模型可能一轮调多个函数,不想要就设 parallel_tool_calls=false。模型肯多发调用已经不稀奇,调用方要自己决定的,还是哪些能一起跑。
想直接试,不用自己实现:LLMCompiler 仓库的更新记录写着它已进了 LangGraph 和 LlamaIndex,LangGraph 仓库里有 examples/llm-compiler/LLMCompiler.ipynb。README 也提醒,官方提示是按非 chat 的 LLaMA-2 70B 写的,换模型要自己调。
先把这张小图画明白,就能看出哪些等待可以去掉,哪些是计算本身必须留下的。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。