跟着买鸟题看
ReWOO 的计划里会出现 #E1、#E2 这样的名字。第一次看容易当成步骤编号,其实后面的工具调用可以直接引用前面的结果:模型写计划时还不知道结果,先给它留个名字,执行时再替换进去。
买鸟题:占位符就是依赖关系
论文 附录 C.3 有道买鸟的题:John 从四位祖辈那里各拿到 50 美元,每只鸟 20 美元,问买到的鸟一共有多少只翅膀。按题目语境,每只鸟两只翅膀,算出总钱数、鸟的数量,再乘二就行。原文的计划多写了一步,下面按原例整理,保留全部调用和返回:
#E1 = Calculator[50 * 4] → 200#E2 = Calculator[20 * (#E1 / 20)] → 200.0#E3 = Calculator[#E1 / 20] → 10.0#E4 = Calculator[#E3 * 2] → 20.0Worker 先拿到 #E1,把 200 代入后面用到它的位置。#E3 得到 10,#E4 接着得到 20,Solver 最后整理成答案。提前知道的只是依赖关系,结果还得等工具返回,所以计划写完不等于所有步骤能同时执行。
占位符的说法来自 Planner 的提示词本身。附录 B.2 里写着:
You can store the evidence into a variable #E that can be called by later tools.
同一段还要求“Each Plan should be followed by only one #E”。一步一个占位符,模型就是在按格子往下填。
#E2 没有后续工具依赖,Solver 仍会收到它
#E2 把鸟的数量乘回单价,又得到总钱数。后面没有工具依赖它,算翅膀也用不着,可 Solver 仍会收到这条证据。这是原例留下的冗余步骤,我觉得很值得保留:它说明 Planner 能产出可用的依赖图,同时也会夹带不必要的工作。介绍时要是替它删干净,就看不到实际生成的计划还有什么问题了。
论文在同一节把 ReAct 的解法也放了出来:先 Calculator[(50 * 4) / 20] 得 10.0,再 Calculator[10.0 * 2] 得 20.0,然后 Finish[20.0 wings]。两次调用对四步,不用我下判断,数一下就知道多了什么。Solver 那边的提示词也提醒“长证据可能包含无关信息,要谨慎使用”,#E2 正是这种会被照单收下的证据。
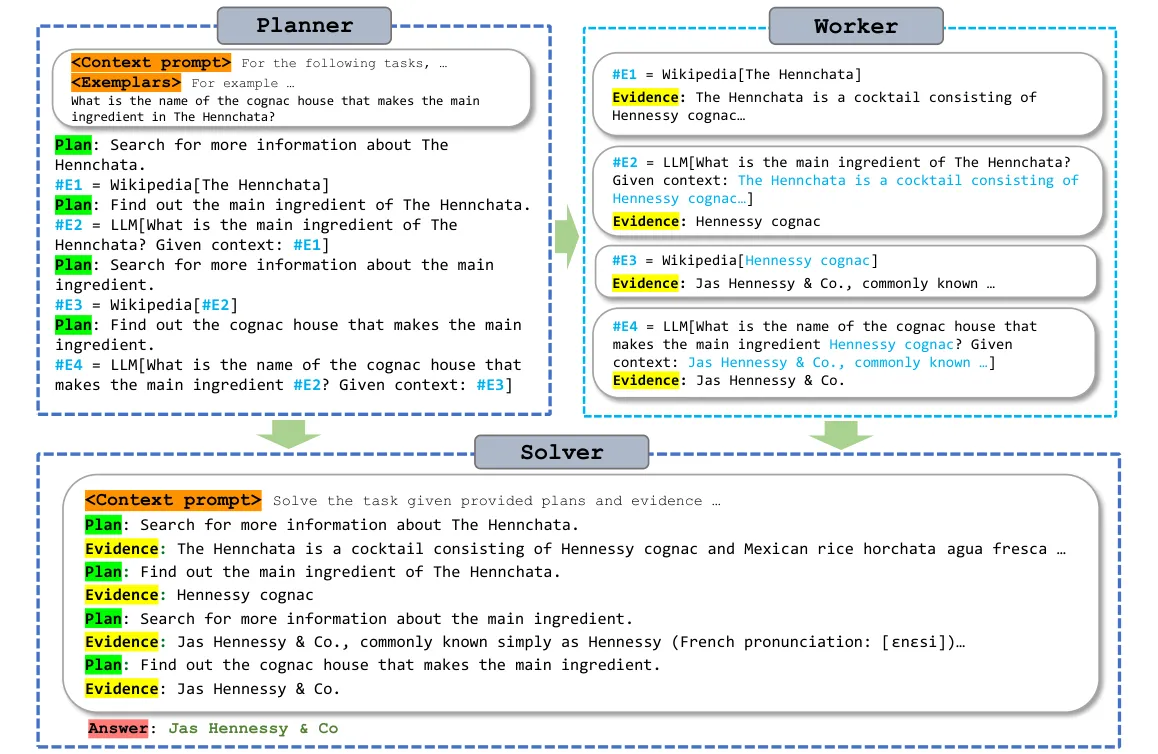
图源:论文 Figure 1,版权归原作者。
三个角色的分工:
- Planner 一次排好任务;
- Worker 按依赖取证据;
- Solver 看计划和结果作答。
比起每拿到一个结果就再问模型下一步做什么,这样少了多次读取整段运行历史。买鸟题每一步算什么题面已经写明,方向都能提前定,用占位符就够。可如果搜索返回一串同名人物,必须先消歧才知道接着查谁,预先写好的计划就可能要调整。§4 的原话更具体:Planner 对环境没有先验,只能枚举所有可能通向答案的计划,遇到没法预判的环境,计划步数就退化成“依赖观察式推理的最坏情况复杂度”。作者给的出路是别把系统做成单体,把 LLM、工具和小模型接成有向无环图(DAG)。
token 省了五倍,精确匹配却降了
HotpotQA 实验用相同工具和六个示例,token 统计也计入了由 LLM 承担的工具消耗的 token(实验表):
| 指标 | ReAct | ReWOO |
|---|---|---|
| 平均每题 token | 9795.1 | 1986.2 |
| Acc(GPT-4 语义评审) | 40.8 | 42.4 |
| F1 | 39.6 | 40.1 |
| EM | 32.2 | 30.4 |
| 平均步数 | 4.97 | 4.45 |
| 每千次成本(美元) | 19.59 | 3.97 |
(Table 2,gpt-3.5-turbo。)节省很明显,但两个准确率口径方向相反。只说一句“准确率提高”,就把精确匹配的下降省掉了。
摘要里的说法是“5× token efficiency and 4% accuracy improvement on HotpotQA”。表里是 40.8 到 42.4,涨了 1.6 个点,4% 是相对值。看这篇的数字,先问基数。
省 token 的机制在 §2.2 和附录 A.1:ReAct 每一步都把同样的提示重新喂一遍,输入 token 随步数近似平方增长。HotpotQA 上主要是示例被重复塞进提示,大约 5 次;ReWOO 的示例不带观察结果,也就没有这种重复。
其他任务也没有统一获益,而且基线换了:
| 任务 | 基线 | 基线得分 | ReWOO |
|---|---|---|---|
| TriviaQA | 不用工具直接回答 | 80.6 | 66.6 |
| GSM8K | CoT | 67.4 | 62.4 |
这两个任务上 ReWOO 都低于自己的对手。和 HotpotQA 那组放在一起,也推不出统一的优势,准确率和 token 用量本来就不是一个量。同一张表里不用工具的 Direct 在 Sports Understanding 上也是最高(68.0)。论文自己算的平均账是六个公开基准省 64% token、绝对准确率高 4.4 个点;没有一个统一的“5 倍”。
错在哪里:论文自己数过
附录 A.2 各抽了 100 道 HotpotQA 错题做分类(标签可重叠):
| 错误类型 | ReAct | ReWOO |
|---|---|---|
| 推理错误 | 76 | 51 |
| 工具低效 | 20 | 29 |
| token 浪费 | 18 | 0 |
| 答偏 | 3 | 11 |
| 题目歧义 | 17 | 17 |
(附录 A.2。)ReWOO 没有 token 浪费,答偏却多了。省 token 不等于少犯错,只是错的样子换了。
工具出故障时差别更大。Table 5 把所有工具返回都改成 “No evidence found”:ReAct 准确率掉 40.8 个点,token 反而多花 851.1;ReWOO 掉 29.2 个点,token 少了 110.8。论文的解释是坏的工具返回会把 ReAct 的推理轨迹带进死循环或重复。ReWOO 这边,坏结果只是没填进某个 #E,计划本身不跟着跑偏。
多余工具也有代价。Figure 6 往提示里不断加工具,准确率总体往下走。作者查了 2 个工具答对、7 个工具答错的 20 道题,17 道是工具误用,比如拿 Yelp[query] 去搜一位名人。
计划提前写好,就能拿来检查和删减
比起这些数字,买鸟题更让我看懂 ReWOO 省了什么、没省什么。#E1 让程序接住结果继续执行,少问一次下一步;#E2 还是白算了一次。计划提前写出来以后,整份计划本身也成了可以检查、删减的对象。作者代码与数据里有更多这样的计划。
论文后半篇把计划当成了训练数据。§3.3 和附录 B.1 用 text-davinci-003 在 HotpotQA 和 TriviaQA 上生成 4000 份计划蓝图,筛掉不成功的,留下约 2000 条,拿来在单张 RTX 4090 上 LoRA 微调一个 7B 的 Planner。结果是在 HotpotQA、TriviaQA、StrategyQA 上追平了大 25 倍的 GPT-3.5。计划能被检查,也就能被筛选和蒸馏。
这篇至今只有 arXiv v1,没有会议版可对照。作者仓库首页说官方(更好的)实现已并入 Gentopia,README 里的 Hugging Face demo 现在显示休眠。
后来:DAG、并行和懒重规划
论文说的 DAG 很快有人做了。LLMCompiler 在 §2.3 点名和 ReWOO 比,列的差异是两条:支持并行函数调用,支持动态重规划。它把计划表示成任务依赖的 DAG,替换完变量就把互不依赖的调用并发派出去。买鸟题里 #E1 之后的步骤都要等它,并不受益;换成搜两个不相干实体的题,并行才派得上用场。
框架层面,LangGraph 的 ReWOO 教程曾用 planner、tool_execution、solver 三个节点,用正则解析 #E\d+ = Tool[input] 再逐个替换变量;这个目录现在只为归档保留、不再更新。IBM 的 Granite 教程照搬了三个角色,但计划是一串写死的子问题,没有纠错和重规划,原来的弱点也一起搬了过去。
“先写完计划”还在被重新测。2026 年的一组实验(正文没点名 ReWOO)比较“一次写完整计划、出问题再重规划”和“边做边想”,两者准确率相当,前者输入 token 少 2–3 倍。我的判断是:ReWOO 的核心想法站住了,计划写成变量依赖确实省;站不住的是“一次写死”,后来的工作都在补重规划这一环。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。