从嵌套键值任务看 MemGPT:数据查得到,模型却可能停得太早。
有一张键值表,A 对应 B,B 又对应 C,C 不再是其他记录的键。问 A 最后对应什么,拿到 B 就回答显然早了一步;拿到 C 以后,也还得确认它是不是终点。
MemGPT 用的正是这种嵌套键值任务,检查模型会不会继续往下查。我觉得它比一句“支持长期记忆”具体得多。
搜索有结果,不等于查到了头
正式题用 UUID,不是容易凭含义联想的 A、B、C。任务底子来自 Lost in the Middle:键和值都是 128 位 UUID,序列化成 JSON,一对相关键值混在一堆干扰项里,原文试了 75、140、300 三档(§3.1)。原任务只要查一跳,让值也能当键、把一跳变成多跳,是 MemGPT 加的。论文 Figure 8 展示的一条路径,保留缩写写成:
查询键 831…ea5 → 找到值 5b8…4c3 → 把 5b8…4c3 作为键继续查 → 找到值 f37…617 → 再查 f37…617 是否出现在 Key 一侧 → 确认终止值后返回 f37…617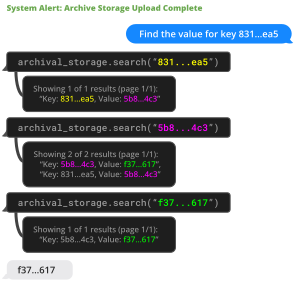
图源:论文 Figure 8,版权归原作者。
最后一次搜索仍可能返回内容相近的记录,所以“搜索有结果”不能当继续的条件。要看匹配到的是不是 Key 字段,以及这个键还有没有下一层值。接口返回了东西、找到了目标记录、走到了链尾,是三次不同的判断。
数据明明在窗口外,也有接口可查,模型仍可能太早停下。MemGPT 允许函数调用完成后继续运行,用分页拿更多结果,直到信息足够再回复用户。一次取太多又会挤满窗口,所以检索本身也得分批。
查到头,靠的是写死的规则
“继续运行”在论文里是一个具体参数(§2.4):模型在函数调用里带上 request_heartbeat=true,处理器就立刻把控制权还给它,接着调下一个函数;不带就是一次 yield,要等下一个外部事件才动。
“什么时候算查完”也没交给模型自觉。附录里 K/V 任务的提示词直接写着:
DO NOT STOP SEARCHING UNTIL YOU VERIFY THAT THE VALUE IS NOT A KEY.
后面还补一句 “Do not stop making nested lookups until this condition is met.”。所以上面说的三次判断,在实现里是显式指令加上能连续调用的控制流撑起来的。只靠一句“注意别漏”,模型照样会停早。
当前上下文由三部分组成,窗口外的东西要靠函数取回
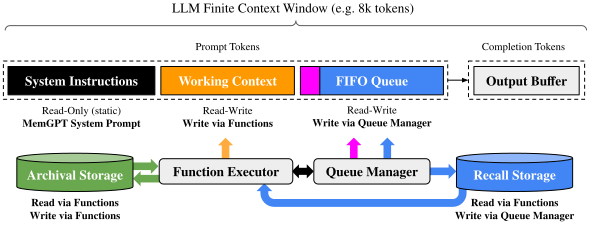
图源:论文 Figure 3,版权归原作者。
当前上下文分三块:
- 只读的系统指令;
- 可写的 working context,放常用信息;
- 先进先出的消息队列,放临时交流。
窗口外还有两处:recall storage 存历史消息,archival storage 放长资料。模型每一步只看得到当前上下文,窗口外的内容不会自己进来,要靠函数把查到的那一段带回来。
队列快满时,系统发出 memory pressure 提示,让模型有机会保存重要内容;达到清理条件后,旧消息移出窗口,并递归整理成摘要。约 70% 容量预警是论文给的一项配置,原文写的是 e.g.,属于举例值;清理阈值的例子是 100%。被逐出的消息和旧摘要一起生成新的递归摘要,放在队列第一位(§2.2)。旧消息退出窗口后仍可回查,所以摘要里没留下某个名字,不等于这个名字永久丢了。其实每条消息一进队列就写进了 recall storage,能回查是因为默认就存了,并非退出时才补存。
这套分层借的是操作系统内存管理的说法,管的却是模型自己的上下文。外部存储和查询函数是真正的系统部件,由应用层配合完成,不是操作系统替模型维护语义记忆。只在提示里加一句“请记住所有内容”,做不到这些。
32.1% 到 92.5%,比的是能读到的材料
深层记忆实验用五段历史会话,再提出第六段里的问题。GPT-4 基线读的是有损摘要,MemGPT 能分页查完整历史:
| 指标 | GPT-4 基线 | MemGPT |
|---|---|---|
| 准确率 | 32.1% | 92.5% |
| ROUGE-L recall | 0.296 | 0.814 |
数字引自论文表 2,我没有复现。它说明完整历史访问很有用,但两边读到的材料不同,不能当成同等输入预算下只换了个提示的提升。
表 2 其实有三行,上面只是 GPT-4 那一行:
| 底座 | 基线准确率 | MemGPT 准确率 |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 66.9% |
| GPT-4 | 32.1% | 92.5% |
| GPT-4 Turbo | 35.3% | 93.4% |
同样的记忆管理,配 GPT-3.5 只到 66.9%,底座本身也在起作用。判分是 LLM judge,口径偏宽:附录里写着,只要答案和标准答案落在同一个话题上就算 CORRECT。
更干净的对照在文档问答那组(§3.2.1、Figure 5):两边用同一个检索器,只改能访问的范围。MemGPT 的表现不随上下文变长而下降,固定窗口的基线大致被检索器的水平封顶。不过同一节也承认,MemGPT 常常在把检索结果翻完之前就停止分页,换 GPT-3.5 时因为函数调用能力有限掉得很明显。“数据在窗口外、有接口可查,模型还是停早”,是论文自己写下的。
这张表后来被质疑过
Zep 在 DMR 上做到 94.8%,比 MemGPT 的 93.4% 略高(Table 1),但它更在意的是指出 DMR 本身偏弱:只考单轮事实检索,每段对话只有 60 条消息,放得进今天的上下文窗口(§4.2)。它还说因为原文方法细节不够,没能用 gpt-4o-mini 复现 MemGPT 的配置。
换到更长的 LongMemEval,Zep 用 gpt-4o-mini 拿到 63.8%,把全部历史塞进窗口的基线是 55.4%;每次进上下文的 token 约 1.6k 对 115k,延迟约 3.2 秒对 31.3 秒(Table 2)。Mem0 的 LOCOMO 表里也有 MemGPT 一行,多跳 F1 只有 9.15,是它四类里最低的一格(Table 1)。
这些数字让我更确信上面的谨慎是对的:完整历史访问的优势,主要在历史塞不进窗口时才成立;而一旦靠检索,查对、查完的责任就落回模型和流程上,多跳恰恰最难。
嵌套键值任务固定 140 对、约八千 token,换用 GPT-3.5 或 GPT-4 Turbo 时仍会提前停止。资料存得下只是起点,连续查询怎么安排、什么时候算查完,都会改变最终答案。
按 §3.2.2 和 Figure 7,嵌套层数从 0 扫到 4,分四种情况:
- 裸 GPT-3.5 到 1 层就掉到 0%,主要错法是直接返回最初那个值;
- 裸 GPT-4 和 GPT-4 Turbo 到 3 层归零;
- MemGPT 配 GPT-3.5 或 GPT-4 Turbo,从 2 层开始下滑,错在查得不够;
- MemGPT 配 GPT-4 不受层数影响,是唯一一直做得完的组合。
GPT-4 Turbo 底座更新,配上 MemGPT 反而不如 GPT-4。多跳查找卡在流程和工具调用上,单步更聪明的模型不一定走得更稳。
这套分层今天长什么样
在今天 Letta 的文档里,记忆块常驻上下文、不用检索;归档记忆不能钉进窗口,只能靠 archival_memory_search(query, tags, page) 这类带分页参数的工具按需查。更新的 MemFS 把根目录文件每轮都放进系统提示,子目录按需读取,默认不建向量索引。常驻和按需这条分界一直没变。
谁来整理记忆倒是挪了位置。Letta 的 sleep-time 方案在后台另开一个 agent 改记忆,主 agent 拿不到改核心记忆的工具,理由是边聊边管记忆会变慢、不太可靠,而且 MemGPT 增量式写记忆,久了会乱。
Anthropic 的 memory tool 走的是同一条路:记忆是一个文件目录,模型用 view、create、str_replace 这几个命令按需读写,系统提示里会自动加一条 “ALWAYS VIEW YOUR MEMORY DIRECTORY BEFORE DOING ANYTHING ELSE.”。和 MemGPT 的 K/V 提示词一样,“先查”被写成了硬指令。
回到 A、B、C:第一个返回没错,直接拿它作答却还是错。如果现在给 agent 接记忆,我会先把“什么时候算查完”写成明确的规则,再去挑存储和检索。论文项目页上保留了这套记忆管理设计。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。