同样叫记忆强度,论文公式里越强越难忘,代码里却越强忘得越快。
Gary 在 5 月 3 日说自己压力大、睡不好,助手给了些建议;5 月 10 日,他问之前推荐过什么。MemoryBank 的表格把这次延迟查询和几个版本的回答放在一起,问的就是一件事:上周说过的话,今天还找不找得回来。这是合成的用户对话,不是真实用户的医疗咨询记录(论文 Table 1)。
记住画像,答不了“上次推荐了什么”
MemoryBank 存三类东西,回答时再检索相关记忆:
- 带时间的对话;
- 每日和全局的事件摘要;
- 用户画像。
Gary 问的是过去的建议,需要的是那次对话本身。只记成“这个人经常有压力”,听着像认识他,原问题还是答不上。
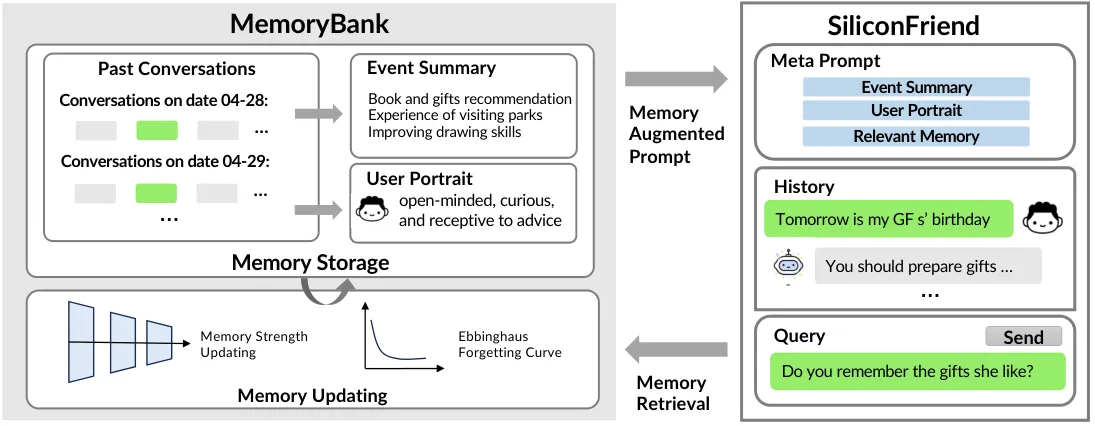
图源:论文 Figure 1,版权归原作者。图中摘要和画像是架构示例,没有展示每句概括怎样从原对话逐步生成。
论文的设计:越常用,忘得越慢
它另外加了一个遗忘设想。论文写的是 R = exp(-t / S):时间 t 越长,保留程度越低;强度 S 越大,下降越慢。新记录强度为 1,每被召回一次强度加一,时间重新计起。
刚召回过的记忆 t 很小,保留程度接近 1,隔得越久才越往下掉;强度加一又让 S 变大,衰减再慢一层。按这个设计,常用到的事会留得更久。
论文自己对这条曲线也没打包票。§2.3 把它叫作“探索性的、高度简化”的记忆更新模型,只取了遗忘速率、时间衰减和间隔效应三条规则;式子之外没有任何常量,没说保留度低到多少算忘、t 用什么单位。引言把“有无遗忘机制都适用”列成第三条贡献,正文却没有一组关掉遗忘的对照实验。遗忘这件事,论文从头到尾没测过。
代码里的一行,把方向反了过来
读固定版本的 forget_memory.py,实际这一行是:
return math.exp(-t / 5*S)Python 对这里的除法和乘法从左往右算,相当于 exp((-t / 5) * S),5*S 并没有整体进分母。只看这一行,很容易顺着论文读成“强度越高越不容易忘”,代两个数进去就会发现方向相反。
区别在 S 的位置。论文里它在分母上,起稳定作用;这一行里它乘进了指数,成了衰减的倍率,t 为正时 S 越大,指数越负。这个方向和 t 取 5 无关,换任何正的 t 都一样。
| 同样取 t = 5 | S = 1 | S = 2 |
|---|---|---|
| 论文公式 exp(-t / S) | 约 0.0067 | 约 0.0821 |
| 该代码表达式 | 约 0.3679 | 约 0.1353 |
表里只是公式计算值,不是实验跑出来的留存率。换个更贴近日常的尺度:第三方的 Agent Memory Atlas 审计算过,按这个表达式,S=1 的记忆隔一天还留约 82%,S=10 的只剩约 13.5%。召回一次强度加一,等于每记起一次就把它往遗忘推一步。第二行里,强度增加,保留概率反而下降。代码随后拿随机数和这个概率比较来决定遗忘,召回更新函数也确实会把强度加一、改写最后召回日期,所以这个差异会实际影响这份固定版本的行为。
论文没写的判定细节,代码里都有:t 是按 %Y-%m-%d 算出的天数差,遗忘只在加载记忆时(initial_load_forget_and_save)发生,判据是 random.random() > retention_probability;检索相关的常量有 VECTOR_SEARCH_TOP_K = 6。那个 5 也是论文里没有的实现选择。
不是一开始就写错的
翻提交历史更有意思。仓库首次提交 “upload code v0” 里这一行还是 return math.exp(-t / S),和论文一致;2023 年 5 月 21 日那次 “update memory forgetting mechanism” 把旧的按日查表改成按 memory_strength 算概率加随机判定,式子也在这次变成了 -t / 5*S。之后 这个文件的提交记录 再没动过它,main 上至今是改后的版本。我上面钉的那个 SHA 其实只是一次 README 合并,读到的代码和今天 main 上一样。
同一个函数的文档字符串偏偏写着 “The higher the memory strength, the slower the rate of forgetting”。注释照着论文说,代码往反方向算,读的人顺着注释读错一点也不奇怪。上面那份审计也建议补一条方向性单测:断言 forgetting_curve(t, 10) > forgetting_curve(t, 1)。一行就能拦住。
评测把“找到”和“答对”分开算
定量评测用 15 名虚拟用户的十天对话、194 道探测问题,检索和回答分开打分,回答得分允许部分正确。英文条件下:
| 版本 | 检索得分 | 回答得分 |
|---|---|---|
| ChatGPT | 0.763 | 0.716 |
| BELLE | 0.814 | 0.479 |
分开以后才看得出,记忆取回来了,是不是真被用对了。
把论文 Table 2(§4.2)的中英两组都摆出来,名次对不上更明显:
| 版本 | 检索(英) | 回答(英) | 检索(中) | 回答(中) |
|---|---|---|---|---|
| ChatGLM | 0.809 | 0.438 | 0.84 | 0.418 |
| BELLE | 0.814 | 0.479 | 0.856 | 0.603 |
| ChatGPT | 0.763 | 0.716 | 0.711 | 0.655 |
ChatGPT 的检索得分在两种语言里都是三者最低,回答得分却在英文组最高;BELLE 检索最好,回答一般。取回来的东西多不多,和最后答得好不好,不是一回事。
后来的考卷上,MemoryBank 接近垫底
论文那套 15 人、十天、194 题的评测后来没人沿用。今天这类系统的公共考卷是 LoCoMo,它在摘要里就说此前工作只评到不超过五段对话。Mem0 的 Table 1 把 MemoryBank 拉上去重测,单跳、多跳、开放域、时序四类的 F1 是 5.00、5.56、6.61、9.68;MemoryOS 也拿它做对照,直接写 “MemoryBank performs the worst”,效率表(Table 3)里它只召回 432 个 token、调 3.0 次模型。省是省,但几乎答不上。这些都是别人复现的数字,不是作者跑的。
还有个小插曲,毛病和本文说的一样:同一组四对数字,在 Mem0 和 MemoryOS 两张表里挂的列名不一样,“9.68”在一张表里算时序,另一张算多跳。转引 MemoryBank 在 LoCoMo 上的成绩,最好按表头逐列核对。
遗忘曲线这条路也没成共识。MemoryOS 改用“热度”在记忆层之间搬运和淘汰,访问次数、交互长度、时间各占一项,并下结论说只靠衰减管不好对话记忆;A-MEM 干脆不做遗忘,改成卡片式链接和记忆演化;Zep 用时序知识图谱,旧事实被新事实推翻时给边打上失效时间,而不是删掉。一篇 2026 年的诊断研究把“写什么”和“怎么取”拆开对照,结论是失败多出在检索那一侧,零 LLM 调用的原始分块不输昂贵的抽取式写入。MemoryBank 花心思的更新与遗忘,恰好在影响较小的那一侧。
我会把公式和代码并排留着。两边都叫记忆强度,同样加一,表里却往相反方向变。复用这个版本之前,先把这个表达式处理掉,顺手补上那条单测;如果只是想要一个长期记忆模块,我会先看检索做得好不好,遗忘曲线排在后面。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。