两条官方记录:看反思怎样进入代码,以及一条把错误解释坚持到底的反思。
Reflexion 的 HumanEval 结果文件里,有一道拆括号的题 separate_paren_groups:忽略空格,把多个平衡括号组分别取出,组内嵌套保持不动。反思记录说,之前把嵌套括号错拆成了独立组。最后的解法逐字符处理,只有整个外层组闭合时,才把累积内容放进结果。
这条官方记录 标记为成功。结果文件只存了反思和最终解法,没有完整的逐轮测试轨迹。
括号题:反思说中了该改的条件
为了说明最终解法检查的是什么,用一个自拟输入:
输入:(()()) ()应得到:['(()())', '()']
前一组内部闭合过几次,都还没有结束最外层括号。等栈清空,才把整个 (()()) 收进结果。
反思如果只说“下次检查仔细一点”,对程序没指出任何位置;说清楚“不要拆开嵌套组”,就能落到“什么时候追加结果”这个条件上。
Reflexion 的思路正是把一次尝试的反馈整理成文字,放进下一次输入,模型参数不更新。它分三个角色:
- Actor:执行,拿出这次尝试的答案;
- Evaluator:看这次尝试的结果,给反馈;
- Self-Reflection:把反馈写成下一次尝试能读到的经验。
这是职责划分,不一定要三套模型。论文 §3 里只有 Actor 必须是 LLM;Evaluator 可以是精确匹配判分、预先写好的启发式函数,也可以是另一个 LLM 实例。经验缓冲通常只留一到三条。留下来的文字能不能用上,要看后面的结果。它和当前这轮的轨迹也不同:跨轮留下的反思让重试不必完全从原题重来。
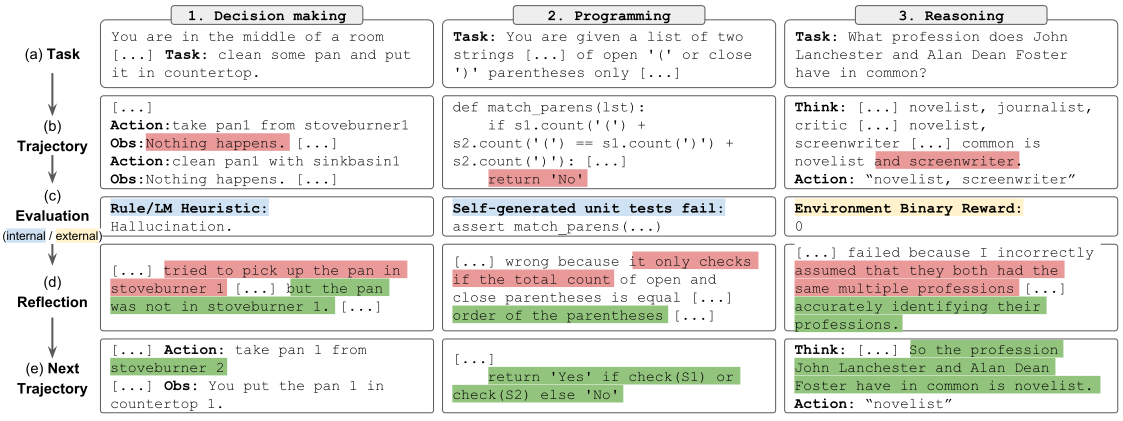
图源:论文 Figure 1,版权归原作者。
循环编码题:同一个误诊写了一遍又一遍
同一份日志里的 decode_cyclic 就没这么顺。题目给的编码器只对长度为 3 的组做循环移动,尾部不足 3 个字符保持原样;反思却连续把“最后两个字符不移动”诊断成编码器有错。结果文件最后是失败,solution 为空。
这两条在日志里是 HumanEval/1 和 HumanEval/38。括号题只有 1 条反思;循环编码题正好 9 条,每条都在说“长度除以 3 余 2 时最后一组没被正确循环”,第 4 条和第 8 条的措辞几乎一样。
原记录显示,反思可以反复维护同一个错误理解。括号题的经验落到了组闭合条件上,这道题却把题目已经写明的规则当成了错误。
反思写得越来越详细,也不一定离正确答案更近。把前一轮反思当成可靠前提往下传,还可能让后面的尝试更难摆脱最初的误诊。
九条反思从哪来:正文说上限 1 条,代码没设上限
论文 §3 说长期记忆有上限 Ω,“通常设为 1-3”,理由是迁就上下文长度;到了 §4.3 的编程任务,写的是最多留 1 条。可 HumanEval/38 攒了 9 条。
翻官方仓库的 programming_runs/reflexion.py,反思是 reflections += [reflection] 一路追加,没有截断。论文 §5 自己也承认,长期记忆只是一个固定滑窗,以后该换成向量库或 SQL 这类结构。所以别把 Reflexion 想成有一个“反思库”在管经验,它就是往下一轮提示里塞几段文字。
这段文字塞在哪,附录 C.2/C.3 写得清楚:一次编程尝试的输入按“指令、函数实现、单测反馈、自我反思、下一次实现的指令”拼起来。反思正好夹在测试反馈和新指令之间,下一轮第一眼就会看到它。误诊写得越肯定,越像一条前提。
仓库里还有一处对不上:run_reflexion.sh 写的是 --max_iters "2",日志里却有题留下 9 条反思。这份日志大概不是用这个脚本原样跑出来的,我没查清,所以下面不按“每题几次尝试”去算成本。
91.0% 背后是多次生成和修订
论文报告 HumanEval Python 最终 pass@1:
| 方法 | pass@1 |
|---|---|
| GPT-4 基线 | 80.1% |
| Reflexion | 91.0% |
同一张表 1 里,别的格子没这么好看:
| 基准 | GPT-4 基线 | Reflexion |
|---|---|---|
| HumanEval Rust | 60.0% | 68.0% |
| MBPP Python | 80.1% | 77.1% |
| MBPP Rust | 70.9% | 75.4% |
| Leetcode Hard Python | 7.5% | 15.0% |
MBPP Python 上不升反降。91.0% 是整张表里最好看的那一格。
最终只交一份代码,但交之前允许多次生成、测试和修订,不能读成第一次生成的成功率。结果文件里有题留下九条反思,反思条数也不能直接当成调用总数。
上面两道题在日志里各是一条记录,代表不了整批题的 91.0%;整批数字也说明不了每道题的重试都走在正确方向上。编程实验还讨论了自生成测试通过、隐藏测试失败的情况:反馈漏掉错误,重试也可能提前结束。
这个比例论文量过(表 2):自生成单测的假阳性率,HumanEval Python 约 1.4%,MBPP Python 有 16.3%。假阳性让 agent 提前交上错答案,正好对得上 MBPP 那一行的下降。顺带一提,单测是模型自己写的,§4.3 说最多采样 6 条,本来就很薄。
没有测试,反思一分不值
论文唯一的消融(表 3,HumanEval Rust,GPT-4)把话说得很直白:
| 设置 | pass@1 |
|---|---|
| 基线 | 0.60 |
| 去掉测试生成 | 0.52 |
| 去掉自我反思 | 0.60 |
| 两者都有 | 0.68 |
没有单测,光靠反思比不反思还差;有测试没反思,也没有增益。反思本身不产生信息,它只是把外部信号转成下一轮能读的话。
别的任务也印证这一点。§4.1 的 ALFWorld 上 134 题完成 130 题;但附录 B.1 的 WebShop 跑了四轮没有显著提升,作者说反思解决不了需要大量探索和多样性的任务。附录表 4 里,弱一些的 starchat-beta 在 HumanEval Python 上加不加 Reflexion 都是 0.26。
后来 Huang 等人把这件事做成了结论(表 1、表 3):没有外部反馈时,GPT-4 在 GSM8K 上自我纠正后从 95.5% 掉到 89.0%;接上 oracle 反馈才涨到 97.5%。他们点名说,Reflexion 这类工作的提升来自 oracle 指导。
反思要对着原题核对
把两条记录放在一起看,反思就是一段下一轮会读到的材料:可能指出一个确实该改的条件,也可能带着一个错误判断反复回来。括号题可以从结果分组核对,编码题可以从原题的尾组规则核对。
今天的框架文档也是这么写的。LangChain 的 Reflection Agents 要求 Reflexion 的 actor 把批评建立在外部数据上,还点出它只走一条固定轨迹,一步走错就会影响后面。Anthropic 的 Building effective agents 里没有“反思”这个词,对应的是 evaluator-optimizer 循环,并强调每一步都要从环境拿到 ground truth、要设最大迭代次数。如果现在要用反思,我会先问:这一轮有什么东西能证明反思说对了?没有的话,就别让它往下传。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。