板球和披萨两个例子看 Mem0 写入前怎么分新增、补充和冲突,以及它后来为什么只加不改。
助手记着一个人喜欢打板球,后来又知道他喜欢和朋友一起打板球。要不要再存一条?全都追加,换个说法就多一份近似记忆;每次覆盖,又可能删掉还成立的信息。Mem0 在写入前先比较一次,判断这句话到底带来了什么变化。
四种操作:新增、更新、删除、不动
官方固定版本的更新提示里有几组例子,按意思整理如下。它们是提示中的示范,不是实际用户数据:
| 旧记录 | 新信息 | 示例中的处理 |
|---|---|---|
| 用户是软件工程师 | 名字叫 John | 新增姓名,原职业记录保留 |
| 喜欢打板球 | 喜欢和朋友一起打板球 | 更新原记录,保留原 ID |
| 喜欢芝士披萨 | 不喜欢芝士披萨 | 删除原来的偏好记录 |
| 名字叫 John | 名字仍是 John | 不作修改 |
代码把四种操作写作 ADD、UPDATE、DELETE、NONE,最后一个表示无需变更。论文正文里同一个操作叫 NOOP,对照着读时别以为是两样东西。板球那条补了信息,没推翻原来的兴趣;姓名重复,连补充都没有。比起一收到消息就塞进向量库,这多了一步判断,也少了以后检索出一堆相近句子的麻烦。
披萨还有一个有意思的示例:原来喜欢芝士披萨,新得知喜欢鸡肉披萨,提示把两者合并保留。没说不喜欢芝士,就不能把新偏好当成替换;明确说了不喜欢,就不能再当原偏好用。区分这些句子靠模型判断,操作枚举只是给判断结果一个程序能执行的形式。论文 §2.1 说得直白:不另设分类器,直接用 LLM 的推理能力选操作。提示里的 UPDATE 是同一个 ID 换文本,同时输出 old_memory 留下旧句,披萨那条就是旧值 “I really like cheese pizza”、新值 “Loves cheese and chicken pizza”。
写入前也要检索一次
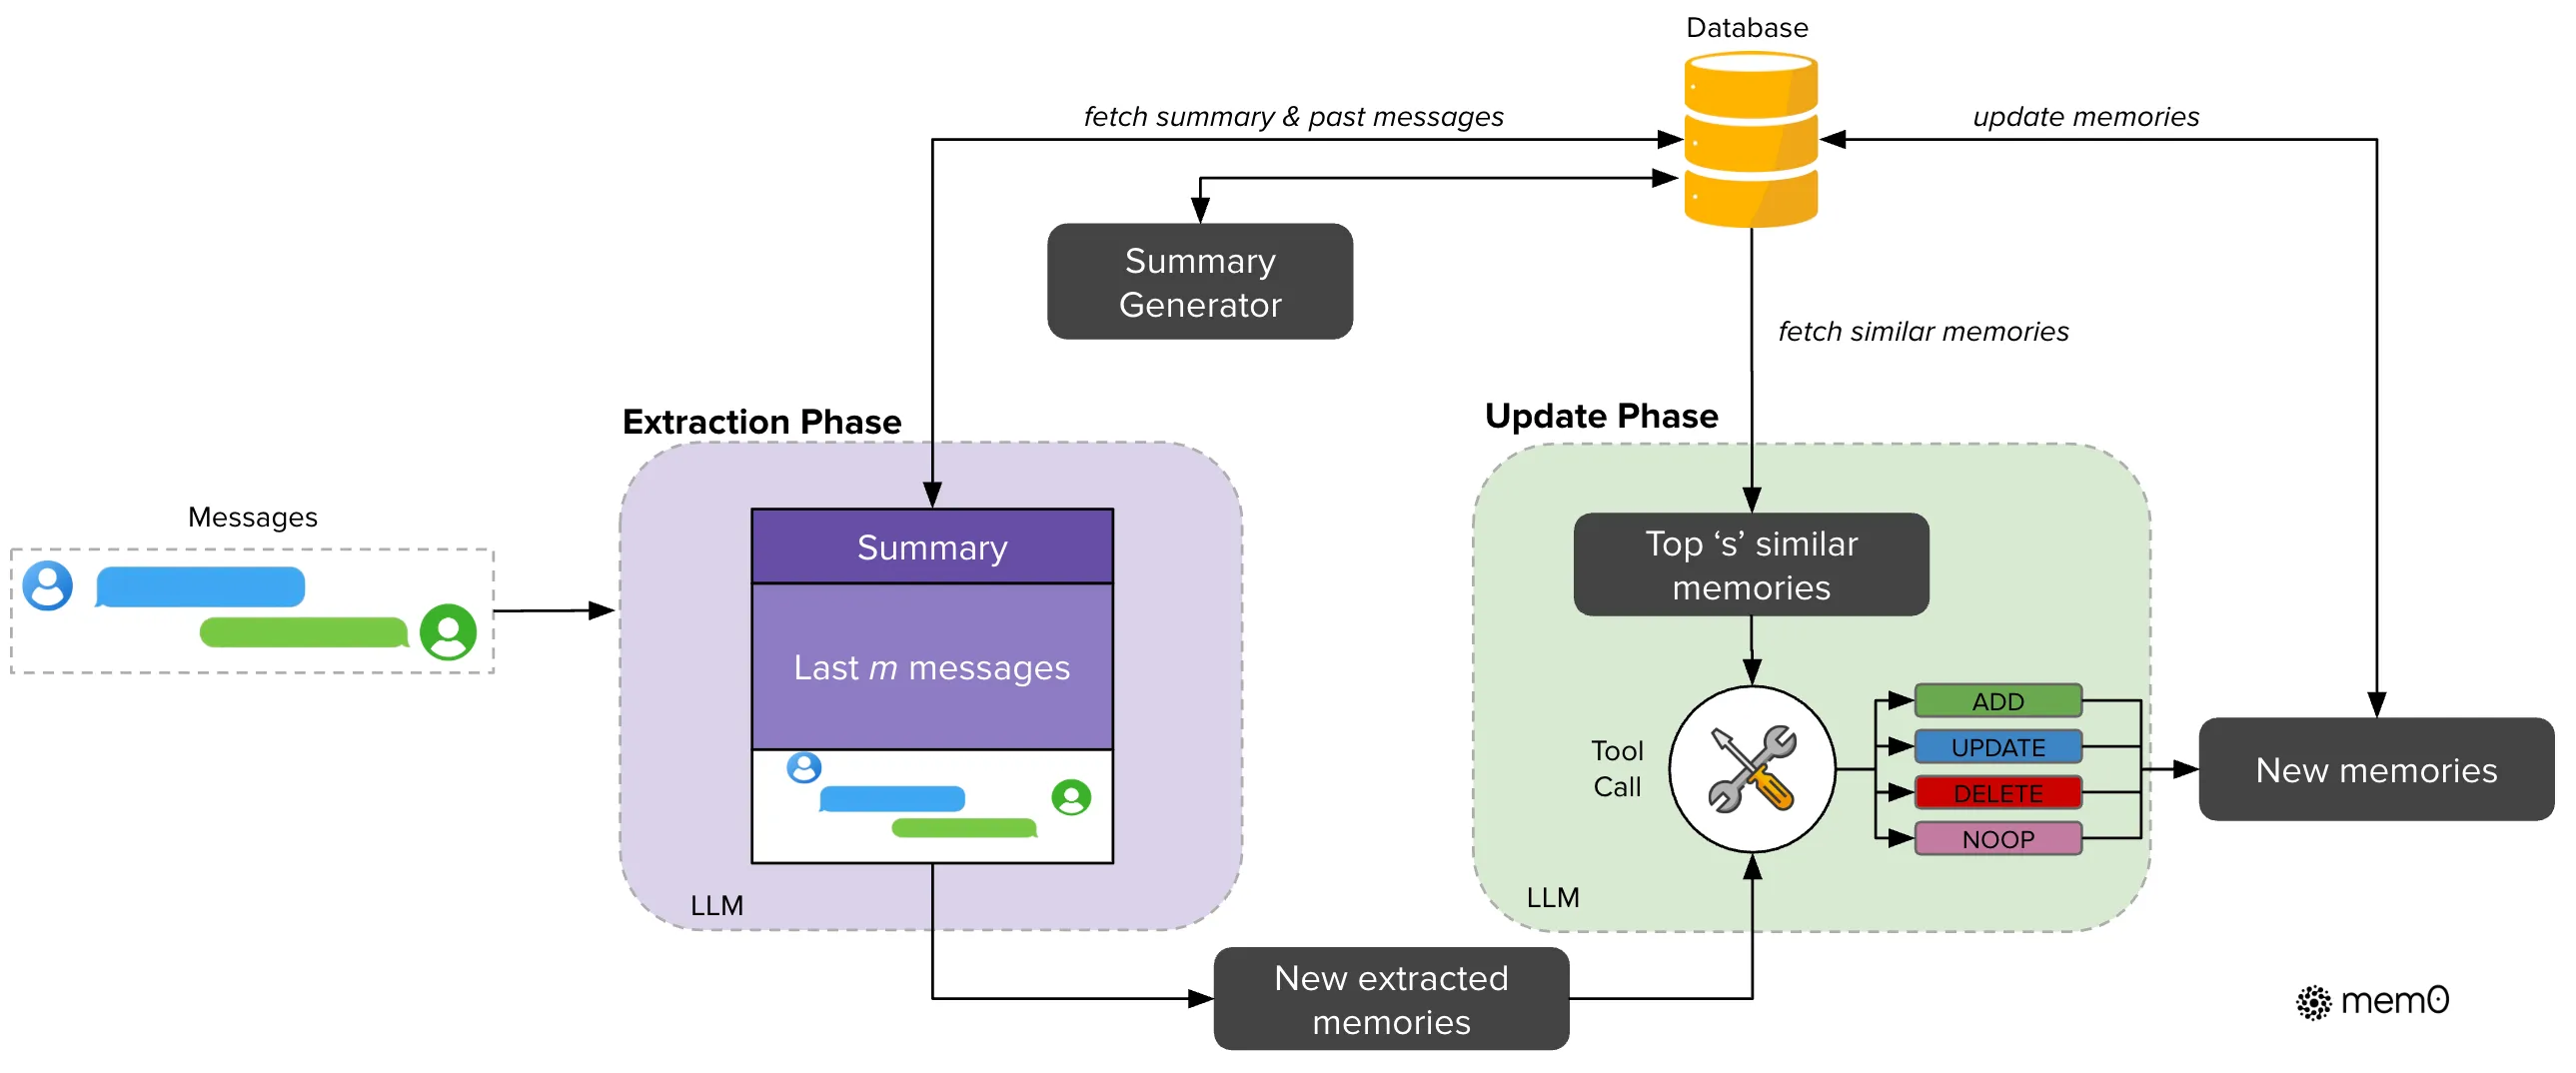
图源:论文 Figure 2,版权归原作者。
按论文 v1,流程分两步:
- 抽取器读当前消息对、近期消息(窗口 10 条)和持续更新的摘要,抽出候选事实;
- 每个候选事实召回 10 条相关旧记忆,交给更新步骤,这一步用 GPT-4o-mini。
这次检索是为了决定怎么写入,和用户提问后检索答案材料不是一回事。输入也不同:写入前拿刚抽出的候选事实去找可比较的旧记录;问答时才拿用户这一轮的问题去找材料。
论文 §3 的配置写明,抽取、更新所有的模型调用都用 GPT-4o-mini。也就是说,每写一次记忆都要跑模型,写入不是免费动作。
抽错了,更新可能认真执行一个错误判断
抽取时删掉一个“不”或一个时间条件,更新阶段就可能认真执行一个错误判断。比如“这周暂住某地”只抽成“住在那里”,操作层选了 UPDATE,也补不回丢掉的“这周”。
先查抽出的句子,再查所选操作,才分得清一次记忆改错是出在抽取还是更新。
准确率让一点,延迟省一大截
论文在 LoCoMo 上比较了压缩记忆和完整历史:
| 指标 | Mem0 | 完整历史 |
|---|---|---|
| 总体 judge 分数 | 66.88 | 72.90 |
| 总响应 p95 延迟 | 约 1.44 秒 | 约 17.12 秒 |
| 总响应 p50 延迟 | 0.708 秒 | 9.870 秒 |
| 每轮读入的 token | 1764 | 26031 |
数字都出自论文表 2,我没有复现。省下来的主要是每轮问答要读进去的上下文:从两万六千 token 降到不到两千。p95 指九成五的请求在这个时间内返回,剩下一小部分可能更久。缩短的是问答时的等待,更新记忆本身仍要持续调用模型。实验结果给出了这项取舍。
按题型拆开看(论文表 1),Mem0 单跳 67.13、多跳 51.15、开放域 72.93、时序 55.51。带图结构的 Mem0ᵍ 时序更高(58.13),多跳反而更低(47.19),论文 §4.2 自己承认图结构在多跳上没带来收益。66.88 是四类题的总分,多跳并不是它的强项。
这些分数要带着口径读
66.88 是 10 次独立运行的均值,温度 0,裁判是 LLM。对抗类题目因为缺金标准,整类被剔掉了。论文说用的是 10 段扩展对话,每段约 600 轮、约 200 题;而 LoCoMo 原论文统计的是 50 段对话、7,512 题,其中对抗类 1871 题,接近四分之一。所以这组比较只用了 LoCoMo 的一部分对话。
这批数字后来被同行按各自口径重算过:
- Zep 发文质疑(博客转载副本):LoCoMo 对话只有一两万 token,本来就塞得进现代上下文窗口;基准里没有知识更新类问题;Mem0 跑 Zep 时把两个说话人都当成 user,检索还串行执行抬高了延迟。Zep 自报更正后是 75.14%。
- Mem0 的联合创始人在 Zep 仓库的 issue 里反击,说 Zep 的 84% 是分子算了第 5 类、分母没算,虚高约 25.56 个百分点,他重跑 Zep 得到 58.44%。
- Letta 团队(做 MemGPT 的)在博客里贴出一个只用 grep、open 这类文件工具的 agent,用 GPT-4o mini 在 LoCoMo 上拿到 74.0%,高于 Mem0 图版的 68.5%。
最后这条最让我在意:一个没有专门记忆机制的 agent 也能超过它,分数里有多少来自记忆设计、多少来自会不会用工具,这个基准分不清。
Mem0 自己后来改成只加不改
前面讲的“写入前比较一次”,是论文那一版的做法。Mem0 的 v2 到 v3 迁移文档说新版只做 ADD,不覆盖也不删除,两件事都保留并带上时间,相关性和新旧交给检索时排序,并说明这是有意为之。开源主分支的默认提示也换成了只有 ADD 的版本,新记忆用 linked_memory_ids 指向相关的旧记忆。
所以拿现在装出来的 Mem0 去验证板球和披萨,会对不上。只加也没消掉“一堆相近句子”的问题,只是换了形式:PR #6288 想解决的问题就是 v3 抽取过度、自托管时没法把召回调低。
同类系统给了别的答案。LangMem 要求把新信息和旧信念调和,删除、作废或合并旧记忆,并提醒抽取过多伤精度、过少伤召回;它的 profile 模式干脆整份覆盖。A-Mem 按 Zettelkasten 建笔记网络,新记忆写入时会反过来改写旧记忆的上下文。路子新不等于分数高,Mem0 论文表 1 里 A-Mem 是 48.38。
全追加、每次覆盖、比较后合并、链接式改写,四种答案各有代价,这类系统都得选一个。
把每次更新的决定留下来
我会把每次更新的决定记下来,排错方便得多。板球那条是补充,披萨那条是冲突,都能拿新旧句子对照。只剩最后一份干净的画像,反而很难知道它是从哪次误读长出来的。
Mem0 开源版其实已经有这张表。storage.py 里的 SQLite history 表记着 memory_id、old_memory、new_memory、event 和创建时间,只插入不修改,get_history(memory_id) 按时间取出。排查一条记忆为什么变成现在这样,从这张表入手就行。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。