拆开 Voyager 技能库里的铁镐程序:存下代码之后,复用还差哪些前提。
Voyager 说自己会积累技能,实际存下的是什么?打开官方技能库,能找到一个 craftIronPickaxe.js。里面没有一大段“制作铁镐的经验”,而是一段读库存、补材料、放工作台、合成物品的 JavaScript。
技能就是一段能重跑的代码
按这份实际技能代码的顺序,可以整理成:
读取铁锭和木棍数量铁锭不足 3 个:挖矿,再冶炼木棍不足 2 根:调用制作木棍的操作在附近放置工作台制作一把铁镐“学会了”由此有了具体内容。下次需要铁镐,不必从头生成所有动作,可以取回这段代码,再和当前任务组合。它也会看库存,材料已经有了就少做些准备。
但检查没有覆盖所有前提,煤和工作台等条件还会影响后续操作。代码曾经能完成任务,换个背包状态,不一定照跑就行。
具体说,它只数了铁锭和木棍。冶炼那行是 smeltItem(bot, "iron_ore", "coal", 3 - ironIngotsCount),直接拿煤去烧,没先看有没有煤;工作台也不查库存,直接 placeItem 在身边放一个。
这类缺口论文自己也列过(§4):GPT-4 会把圆石当燃料,会要求做游戏里不存在的“铜剑”,会调用控制接口里没有的函数;也会卡住、写不出正确的技能,这时靠自动课程把同一任务排到后面再试。
课程、执行、检查,一圈一圈转
Voyager 让模型生成这样的程序,通过 Mineflayer 的 JavaScript 接口操作 Minecraft。输入是文字状态,包括背包、装备、位置和任务等,不要求模型看屏幕像素识别环境。
自动课程根据现状和已完成、已失败的任务提出下一个目标;生成代码时,再取相关技能一起参考。
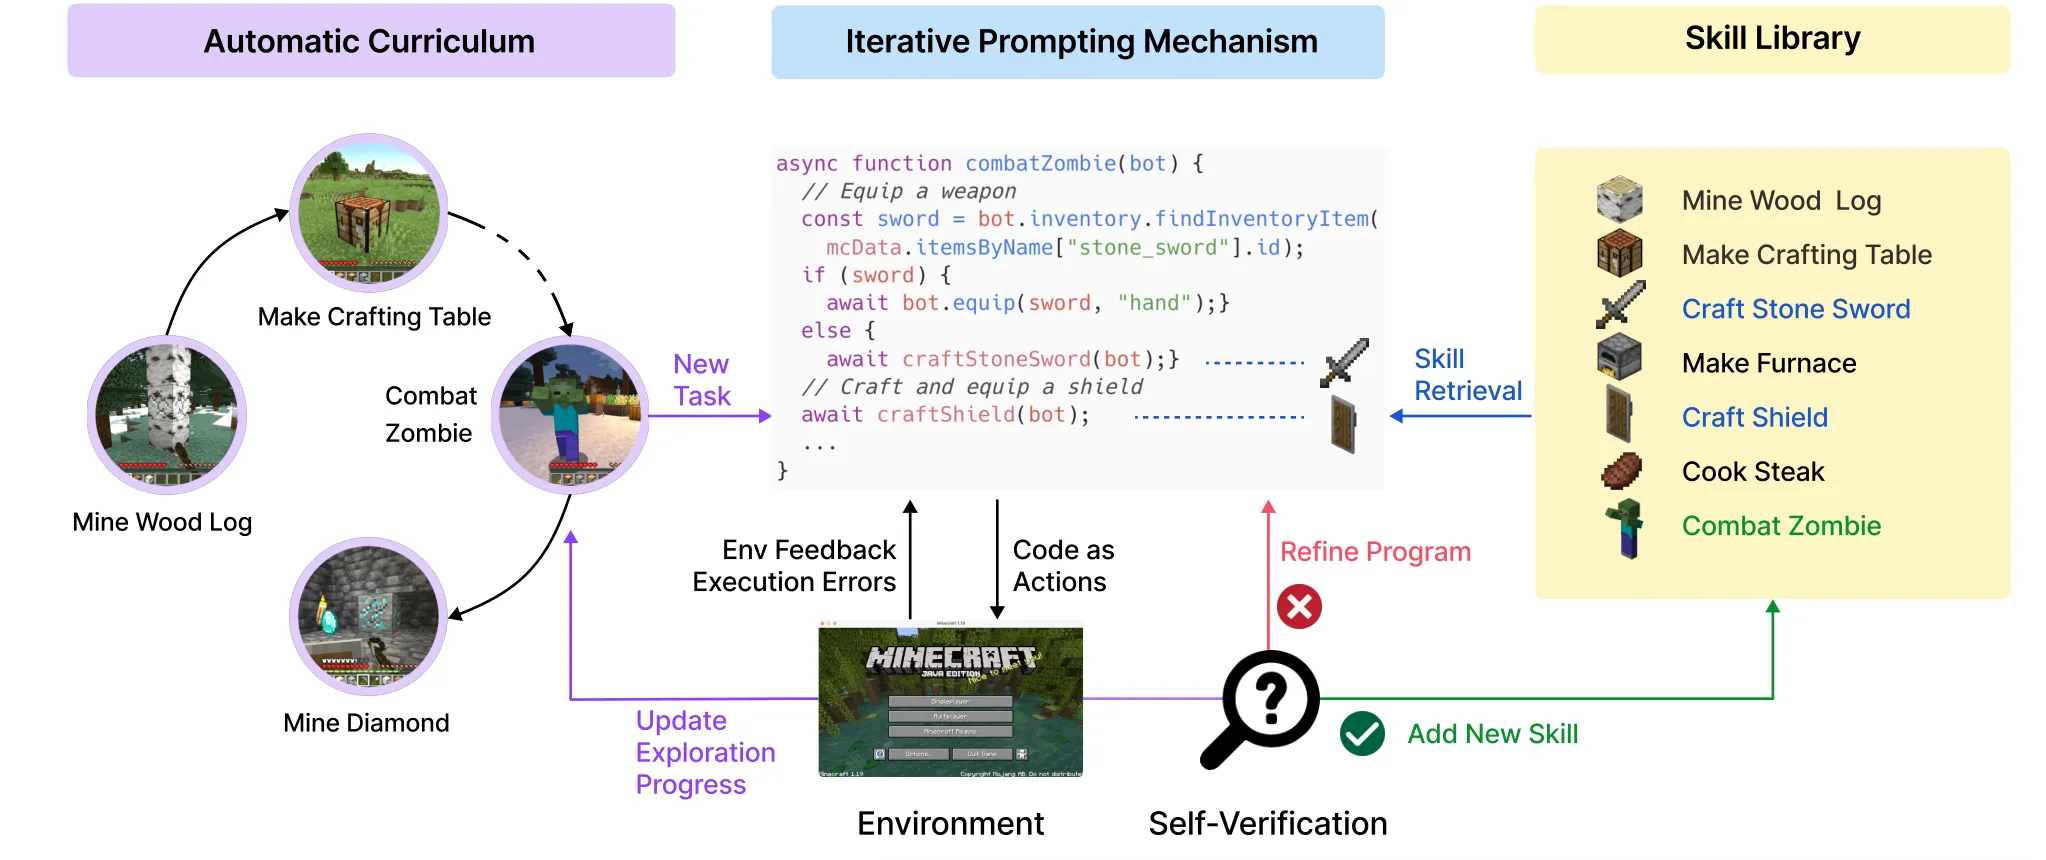
图源:论文 Figure 2,版权归原作者。
程序跑完,还要判断任务完成没有。反馈有三类:
- 环境事件:告诉系统做了什么;
- 代码错误:说明调用哪里出了问题;
- critic:对照输入里的那项任务和当前状态,判断目标有没有达成。
前两类说的是这一步执行得怎么样,critic 管的是任务本身。执行循环把这些信息送进后续提示,下一次修改才有东西可用。
论文附录 A.5.2 有个验证提示示例:库存有工作台、6 块云杉木板和 4 根木棍,目标是制作木镐。验证输出说没完成,因为材料齐了,木镐还没做出来,并提示用工作台、3 块木板和 2 根木棍去做。它不是实际失败日志,但把要查的状态说得很清楚:程序跑完、材料备齐、目标物品出现,是三件不同的事。
积累下来的是代码,参数没动
成功的程序连同描述进入技能库,描述的向量用于检索,每次取最相关的五项给后续任务。看 skills.json 会发现,这个“描述”其实是函数签名加一行注释,比如 async function mineWoodLog(bot) 下面跟着 “The function is about mining a single wood log block.”。探索中模型参数没有更新,攒下的是可调用的代码。到新世界做 zero-shot 复用时,也带着这些旧技能。
这很像攒自己写过的工具函数,下次能直接拿来用,麻烦在于每个函数都有适用条件。
技能库和模型权重也是分开的两样东西。官方 skill_library 说明写得很清楚,checkpoint 里只有 skill 子目录算学到的技能库,可以直接分享给别人,README 里还收了三份社区跑出来的库。
库自己也会长乱
trial1 这份库有 57 个 .js 文件,其中 6 个是 *V2.js。craftIronPickaxeV2.js 和 craftIronPickaxe.js 的函数体逐字相同,连 “// Place the crafting table near the bot” 这句注释都一样。成功一次就存一次,没人合并,同一个技能就存了两遍。
2026 年有篇论文给这种现象起了名字,叫 library drift:库无限增长,近重复和过期的技能把有用的挤出去,最后智能体表现掉到不用技能库的基线以下(§3)。它的实验里,模型自己写的技能相对无技能基线增益为 0,人工整理的有 16.2 个百分点(Table 1)。那是 MBPP+ 代码题上的数字,不能直接算到 Voyager 头上,但它提醒了一件事:复用除了要写清前提,还得定期清理库。
63 种物品这组数字怎么读
论文主要用 gpt-4-0314,辅助任务用 gpt-3.5-turbo-0301:
- 160 次 prompting iterations 中发现 63 种物品;
- 约为作者所用比较基线的 3.3 倍;
- 在那组实验中到达了钻石工具层级。
这些出自论文的实验设置,换模型版本或换个世界,同样的量级不保证重现。在这个范围内,探索结果能说明技能积累的作用。
消融分别移除了课程、技能库和反馈。去掉技能库,只是不能再检索复用已积累的代码,任务里已有的提示和操作接口还在;移走课程和反馈,变的是目标怎么提出、错误怎么进入下一轮提示。
具体数字在论文 Table 1(解锁各层科技树用的迭代次数,3 次运行)和 §3.4:
| 方法 | 木 | 石 | 铁 | 钻石 |
|---|---|---|---|---|
| ReAct、Reflexion | 0/3 | 0/3 | 0/3 | 0/3 |
| AutoGPT | 92±72 | 94±72 | 135±103 | 0/3 |
| Voyager 去掉技能库 | 7±2 | 9±4 | 29±11 | 0/3 |
| Voyager 完整版 | 6±2 | 11±2 | 21±7 | 102(1/3) |
0/3 表示 160 次迭代内一次都没解锁。前三层有没有技能库差得不多,技能库的差别集中在钻石这一层,而且完整版也只有三次里的一次做到。
§3.4 的另外几个量级:去掉 self-verification,发现的物品数降 73%,论文说它是几类反馈里最重要的;自动课程换成随机课程,降 93%;写代码的模型从 GPT-4 换成 GPT-3.5,物品数少 5.7 倍。§4 还提了一句成本:GPT-4 比 GPT-3.5 贵 15 倍。课程和 critic 比技能库本身更关键,这是我读完表格后最意外的一点。
存代码只是当时的一种选法
同一时期的 Minecraft 智能体还有别的做法。GITM 不存代码技能,用结构化动作加文本记忆,摘要里说一台 32 核 CPU 就够训练。后来的 Odyssey 则让人把技能先写好:40 个原始技能加 183 个组合技能,并指出 Voyager 只有 18 个原始技能、全是操作类(§2.1)。模型只负责调用和组合,绕开了“让模型自己写代码”这一步。
今天产品里,Anthropic 的 Agent Skills 把技能做成一个目录:SKILL.md 加 scripts/,分三级按需加载,脚本通过 bash 运行,脚本代码本身不进上下文,只带回输出。技能里放可执行代码、需要时再取,这个思路两年后成了官方做法,只是写技能的多半换成了人。
读一个技能,就给它换个库存
回到铁镐文件。读技能最方便的办法,是假定一种别的库存,逐行想会走哪个分支:铁锭有了、木棍不够,程序会补木棍;材料齐了却没有工作台,后面的放置就得另外处理。
把这些前提写清,才知道下次检索到的代码能直接用多少,还要补多少准备。如果自己搭技能库,我会让每个技能开头先断言它依赖的库存和环境,再定期合并重复条目,比一味往里加更要紧。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。