同一份结果,问“至少成功一次”是 100%,问“每次都成功”只剩 50%;以及模拟用户本身有多不稳。
同一个客服任务跑了四次,前三次办成,第四次失败。从中取两次,我们想知道的是至少一次成功,还是两次都成功?两个问题听着接近,算出来差得很远。
同一组结果,100% 和 50%
下面是为解释指标自拟的结果,六种两次组合全部列出:
| 两次尝试 | 至少一次成功 | 两次都成功 |
|---|---|---|
| 1、2 | 是 | 是 |
| 1、3 | 是 | 是 |
| 1、4 | 是 | 否 |
| 2、3 | 是 | 是 |
| 2、4 | 是 | 否 |
| 3、4 | 是 | 否 |
前一种是 100%,后一种只有 50%。τ-bench 关心的是后者,用 Pass^k 表示同一任务独立重复多次、全部成功的能力,和通常问“至少成功一次”的 pass@k 不一样。
客服处理一张订单,用户得到的就是这一次服务。别的尝试办得再好,也补不上当前这次失败。
助手、模拟用户和一个目标终态
论文给助手零售或航空的业务规则、数据库和工具,另一个模型扮演用户。用户知道自己的意图,助手要通过对话问清,评测器另有目标结果。任务因此包含问需求、查信息、确认和修改状态,不能只看回复好不好听。
两个领域的规模不大(论文表 1):零售 500 个用户、50 种商品、1000 张订单,7 个写工具加 8 个读工具,115 道题;航空 500 个用户、300 个航班、2000 条预订,6 个写工具加 7 个读工具,50 道题。数据库对助手和用户都不可见,只能通过 API 读写。
扮演用户的是 gpt-4-0613。它只看得到任务指令和对话,看不到助手调了哪些工具;它说出 ###STOP###,这一次服务就算结束,开始评分。
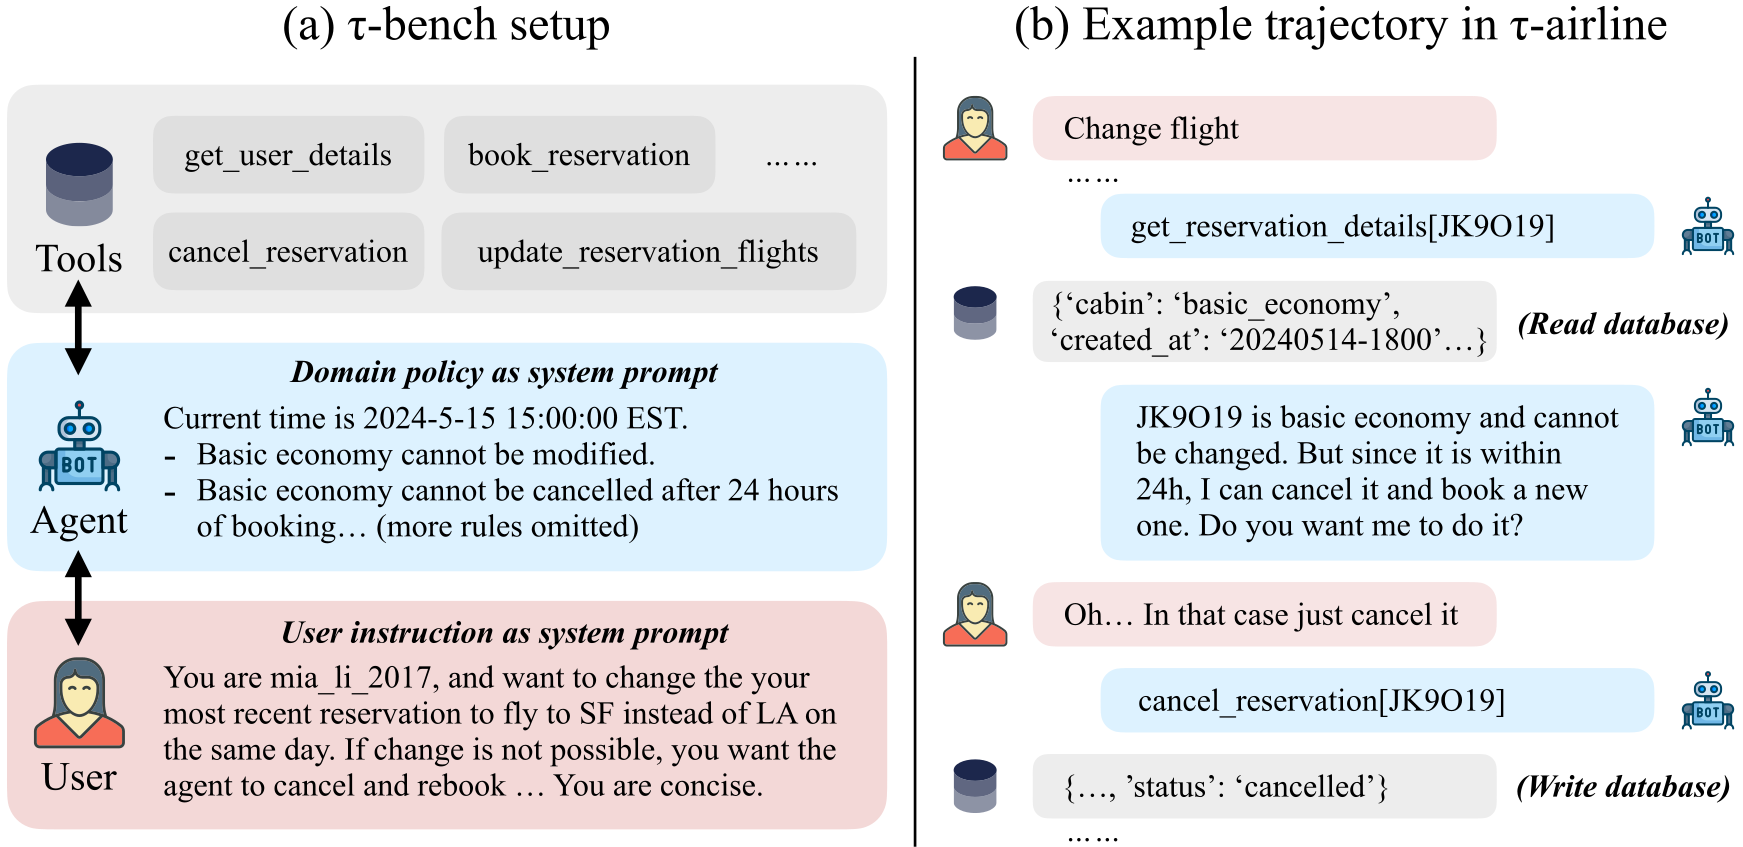
图源:论文 Figure 1,版权归原作者。
再自拟一个例子:一张订单要换两件商品,假定业务规则只允许提交一次换货。助手先办好第一件,随后才问第二件的规格,就可能把订单卡住。第一次工具调用成功,和整个用户要求完成,不是一件事。要检查的是最后订单里究竟换了什么,客服说没说“已经办好”不算数。
奖励看终态,过程只能部分检查
奖励看两件事,都满足才给 1:
- 最终数据库是否符合目标;
- 回复里是否含指定信息。
不同对话路线可以到达同一个终态。但有些过程要求靠终态判断不了,比如助手未经确认就操作,却碰巧改出了正确结果。作者也说明了这种过程检查的不足,原话是:
r=1 might be a necessary but not sufficient condition for a successful episode
Pass^k 的可靠性仍建立在当前的成功定义上。
论文表 3 的消融给了一个具体例子。把领域规则从系统提示里拿掉,零售几乎不动(gpt-4o 掉 4.4%,gpt-3.5 掉 5.5%);航空里 gpt-4o 掉 22.4%,gpt-3.5 只掉 1.2%。论文的解读是零售靠常识就能做对,航空规则复杂,弱模型本来就没在用规则。换句话说,零售的终态对了,不一定是因为规则被遵守了。
Pass^k 要按任务算,再平均
每道任务有 n 次尝试、c 次成功,k 次全部成功的组合比例是 C(c, k) / C(n, k),再对任务取平均。上表就是 C(3, 2) / C(4, 2) = 3/6。
不能先把所有任务合成一个平均成功率再取 k 次方,因为任务难度各不相同。同样的 n 和 c 换个问法就是 pass@k:1 减去 k 次全部失败的比例 C(n - c, k) / C(n, k)。k 为 1 时两式相等,Pass^1 就是 pass@1。
GPT-4o 的零售成绩,重复八次掉到 25% 以下
原生 function calling 的 GPT-4o:
| 领域 | Pass^1 |
|---|---|
| 零售 | 61.2% |
| 航空 | 35.2% |
零售的 Pass^8 已低于 25%。成绩来自论文,我没有复现。主结果每题至少跑三次,助手温度 0,用户模拟器温度 1,最多 30 个动作(包括对用户说话)。
助手温度为零,也不代表每次交互完全一样。论文设置与结果给了解释:同一道题的提示和数据库起点相同,但用户模拟器按温度 1 采样,同一件需求的问法可能不一样,助手接下来的动作也可能不同。所以 Pass^k 量的是:语义相同的需求换个说法,助手还能不能办成。
同批 12 个模型里,GPT-4o 是最好的那个,不是挑出来的特例。几个对照(Pass^1,零售/航空):
| 模型 | 零售 | 航空 |
|---|---|---|
| gpt-4o | 61.2% | 35.2% |
| claude-3-opus | 44.2% | 34.7% |
| gpt-3.5-turbo | 20.0% | 10.8% |
| llama-3-70B(文本 ReAct) | 14.8% | 14.4% |
论文还提醒,表里的平均分按领域加权,不按题数加权,零售 115 题、航空 50 题差了一倍多。这和上一节“先按任务算再平均”是同一类问题:怎么平均,本身就会改变数字。
失败长什么样
论文 §5.2 拿 gpt-4o 在零售的 115 条轨迹(每题一次,这次 Pass^1 是 65.2%,和上表不是同一次运行)逐条看了 40 条失败:
- 4 条是题目本身有拼写错误或含糊,论文随后修了;
- 决策错误最多,占失败的 25%;
- 复合请求只办了一部分,占 19%;
- 复杂的数据库推理导致参数或信息出错,约 5%。
上面那个换货例子的情形,论文附录里有真实案例:助手没注意一次性换货的规则就先提交了。
另一种失败更隐蔽:工具调用本身“成功”,参数里的 ID 却不存在。gpt-4o 平均每道零售题 0.46 次用编造的用户、商品或订单 ID 调工具,gpt-3.5-turbo 的 function calling 版是 2.08 次,纯文本 ReAct 版 6.34 次。
模拟用户自己也不稳
Pass^k 说的稳定,是面对某个模拟用户时的稳定。这个用户本身有多可靠,后来被量过几次。
2025 年的后续 τ²-bench 抽查原版对话:航空 47% 的对话里模拟用户出了错,13% 是严重错误;零售是 40% 和 12%。另一篇 Lost in Simulation 在零售任务上换不同的用户模型,助手成功率最多差 9 个百分点。Mind the Sim2Real Gap 找了 451 个真人跑完整协议,结论是模拟用户太配合、风格单一、缺少真实的不耐烦和含糊,等于给助手开了“简单模式”,把成功率抬高到真人基线以上。
题目也有账。SABER 指出标注错误和欠定义的题人为压低了上限,发布了修正版 τ-Bench Verified。它还发现,真正改数据库的那几步偏离一次,成功几率最多降到原来的 8%(航空)和 4%(零售),只读的步骤偏离几乎没影响。这和换货卡单的例子是一回事:要命的是动状态的那一步。
官方的反应写在仓库 README 里:这份仓库的航空和零售题已经过时,指向新版;用户模拟器多了一个 verify 策略,再调一次模型检查模拟用户的回答合不合格;另有脚本把失败归因到用户、助手或环境,但 README 也提示做归因的是 LLM,可能不准。
展示用 pass@k,服务看 Pass^k
这套指标让我更容易分辨展示和服务。要找一条能完成任务的轨迹,“至少成功一次”有意义;要反复处理用户请求,就得看同一个任务到底有多稳。
1 − C(n − c, k) / C(n, k) 这个式子来自代码评测:HumanEval 论文 §2.1 用它做 pass@k 的无偏估计,每题采 200 个样本。那是为“采很多次,找一条能跑的代码”设计的,τ-bench 把同一组 n 和 c 反过来读,问的是每次都能不能办成。
要这么严格,就得多跑很多次。论文算过零售一题的成本:gpt-4o 助手 0.38 美元,gpt-4 扮演的用户 0.23 美元,全量跑一遍约 200 美元,95.9% 的 token 是输入。Pass^8 就要再乘 8。
今天的官方榜单上,τ²-bench 的头部 Pass^1 已经到 85% 上下,题目在 2026 年 2 月又审修了 50 多道。但三张榜的主列都还是 Pass^1。我的读法是:Pass^k 仍更像可靠性的脚注,没成为展示口径,而服务场景真正该看的恰恰是它。
上表没有增加任何新结果,只是换了个问题,完美的 100% 就成了 50%。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。