用综述自带的电影推荐例子,分清这次取到的片单和以前留下的偏好。
Alice 想下班后看电影。助手记得她通常晚上九点看,先问时间合不合适;得到确认后,取来她的想看列表,里面有《星际穿越》等几部。它还记得 Alice 晚上不看恐怖片,于是选了《星际穿越》,再问她喜不喜欢。
这是 2024 年 Agent Memory Survey 自带的假设案例。例子很小,正好能把几种容易混在一起的信息分开。
原文的片单其实有三部:Interstellar、Planet Terror 和 Candle in the Tomb(鬼吹灯)。后两部是恐怖片。助手说“Alice 晚上从不看恐怖片”,把它们挑掉,旧记忆起作用的那一下,在例子里看得清清楚楚。
三种信息,不是同一次取得的
- 刚取回的片单,是这次交互拿到的;
- 晚上的观影习惯,来自过去的记录;
- Alice 这次说“喜欢”,是可以写入的新消息。
它们都影响推荐,来路却不同。只问“助手有没有长期记忆”,看不到中间做了什么。它可能存了全部聊天,却没取出不看恐怖片的偏好;也可能读到了偏好,整理时又删了适用范围。前一种出在读取,后一种出在管理,要改的地方不同。
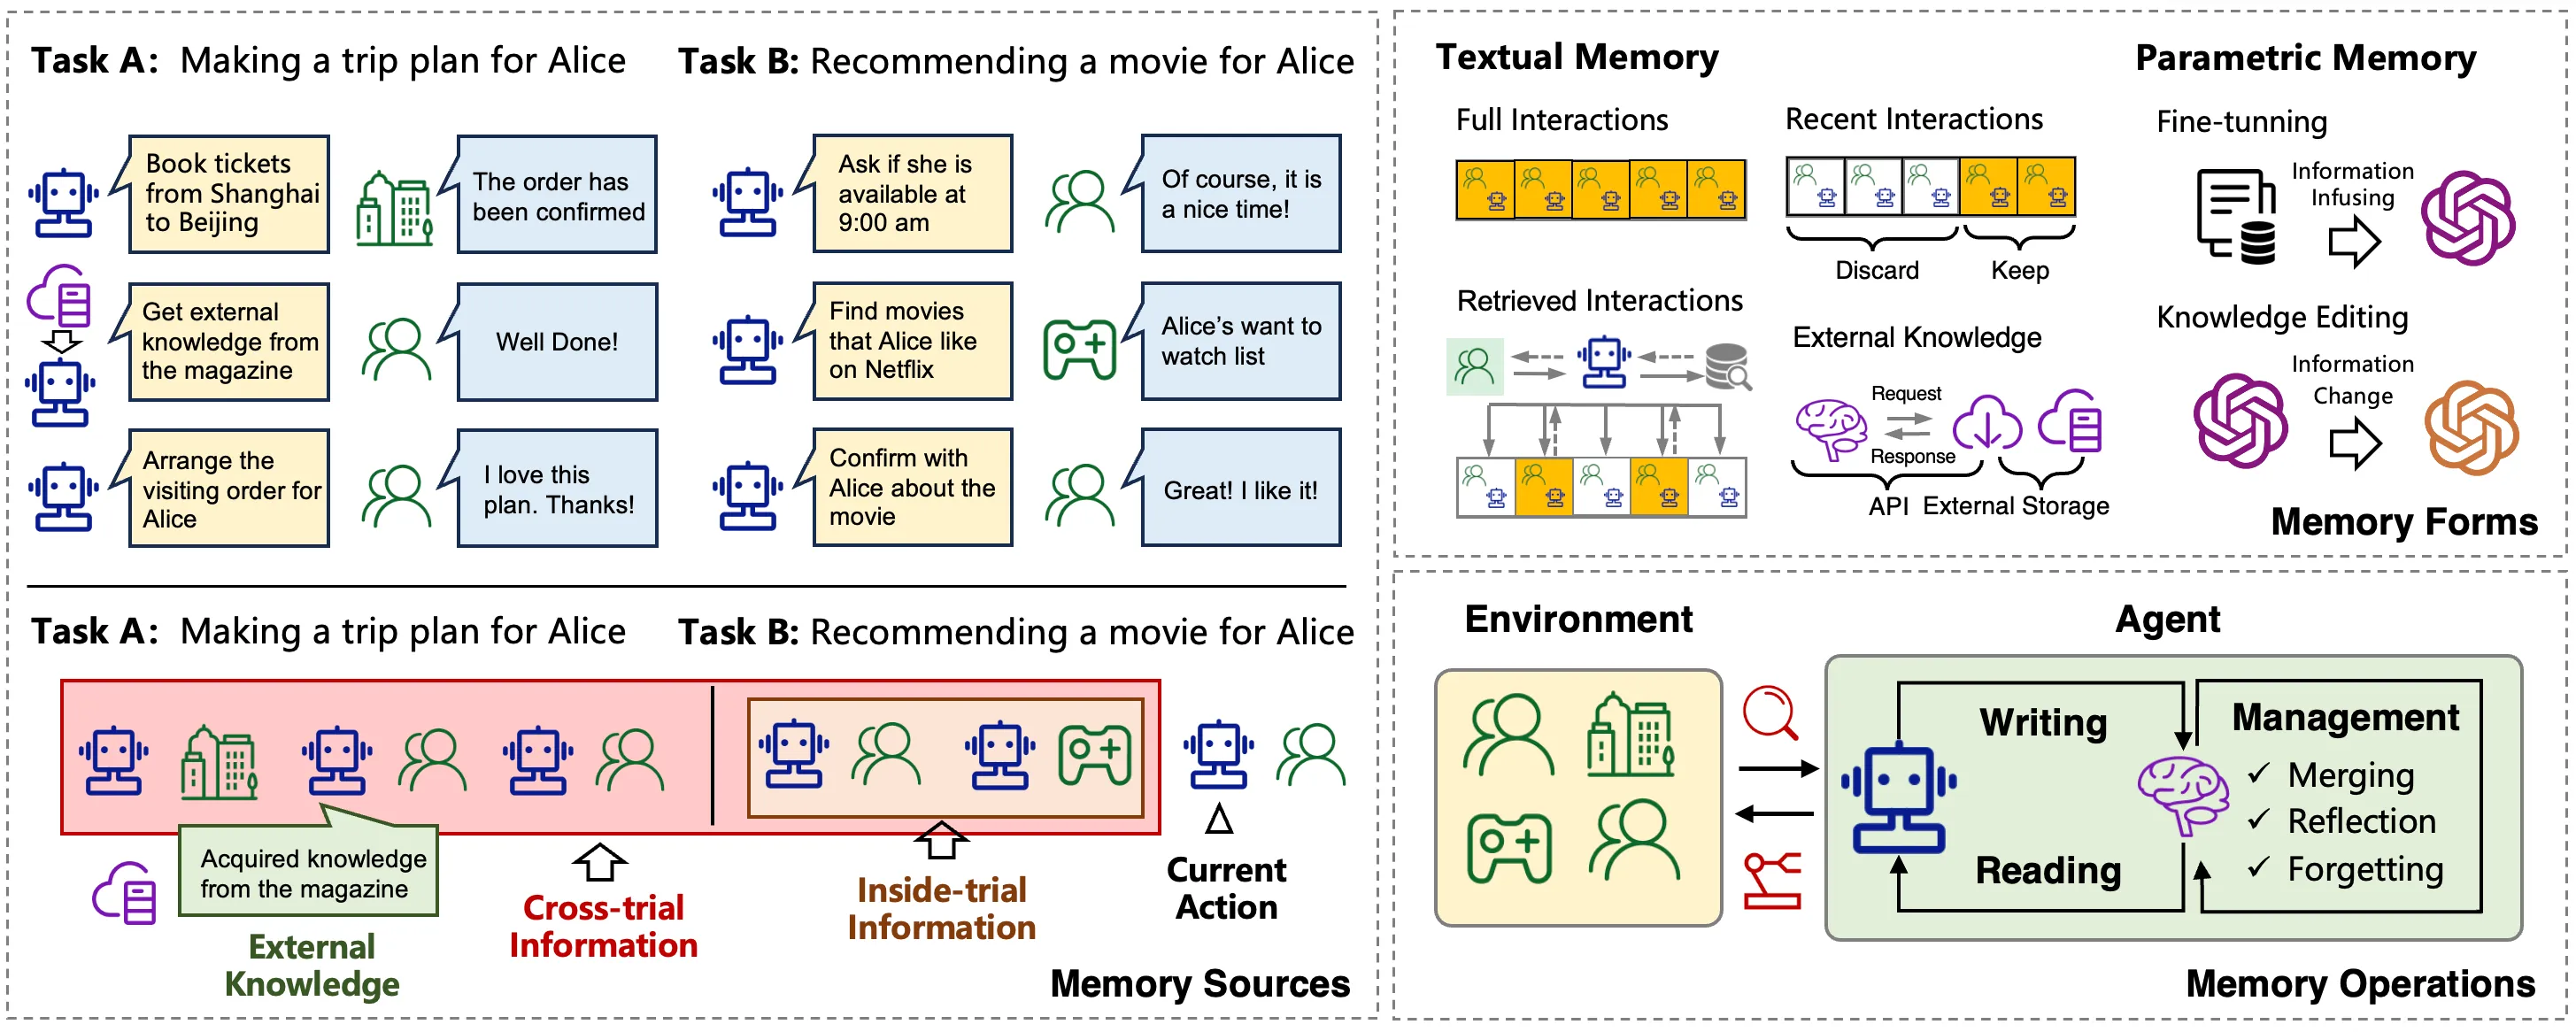
图源:论文 Figure 4,版权归原作者。左上电影例子按正文应为晚上九点,图中写成上午九点;本文按正文说明。
“她今晚喜欢”怎么变成了“她喜欢”
论文把记忆操作分成写入、管理、读取三类。放到这个例子上:
- 写入:存下 Alice 这次的确认;
- 读取:找到当前选择需要的片单与偏好;
- 管理:夹在中间,可能合并记录、反思或遗忘。
原文把这次交互整理成“Alice 喜欢晚间看科幻片”,已经从一次对话变成了更概括的描述。读取那一步,论文也写得很收敛:只在第 2 步取回的想看列表里挑一部,不另外生成新选项。
管理在论文 §5.3.2 里有三个子动作:反思出更高层的记忆、合并冗余条目、遗忘不重要的早期记忆。“喜欢晚间看科幻片”这种概括,对应的是反思。
读到这里,我想给那条偏好留一个原文入口。一次说喜欢《星际穿越》,并没有回答她是否喜欢所有科幻片、是否每晚都愿意看。这个概括拿来说明管理操作很直观,真用来推荐,我还是想知道它来自几次选择。哪天 Alice 说今晚想看喜剧,也应该能直接更新安排,不必先和一条写得过于笃定的偏好较劲。
遗忘几乎没人做
管理是这几步里最少人认真做的。综述表 3 统计了 28 个系统的记忆操作,遗忘那一列只有 MemoryBank、TiM、Generative Agents、RecAgent、S3 五个打了勾,其余要么没有专门设计,要么论文根本没讨论。
一年多后,主流实现对“新信息和旧记忆冲突怎么办”还是给出了相反的默认:
| 实现 | 新旧冲突时 | 出处 |
|---|---|---|
| Mem0 论文 | LLM 在 ADD / UPDATE / DELETE / NOOP 里选一个 | Mem0 论文 |
| Mem0 文档的 add | 只加不覆盖,可设过期时间让旧记忆从检索里消失 | Mem0 文档 |
| LangMem | 让新信息和旧信念协调,删除、作废或合并旧记忆 | LangMem 概念指南 |
| Letta | 主 agent 不能改核心记忆,交给后台的 sleep-time agent 异步整理 | Letta 博客 |
Alice 说“今天例外”,该覆盖那条偏好、加一条新记录,还是什么都不动,这几种实现会给出不同答案。Letta 的做法最接近我想要的分工:管理变成一次离线的第二轮对话,记忆用 git 版本化(Letta 文档),哪次改了什么能翻出来。
这张片单,我倾向存文本
存完整对话好回查,存短事实便于检索,两种可以一起用。两边各有代价,论文 §5.2.1 都列了:存完整交互,注意力计算随长度平方增长,超出上下文还得截断丢信息;只留近期记忆,远处的关键信息取不回来;检索不准,又会带回无关内容。
综述还讨论参数形式的记忆,比如微调与知识编辑。这种记忆的改动落在一次训练或编辑上,改完不容易指出来自哪次对话。原因在机制上:论文 §5.3.3 说参数记忆直接用更新后的参数推理,算是一种“隐式读取”,这条路上没有一个能单独检查的读取动作。
代价论文也自己列了。微调有灾难性遗忘,而且在线交互里每一步都反向传播是负担不起的;知识编辑要付 meta-training 成本,还难保住无关的记忆(§5.2.2)。后来有实证:EMNLP 2024 的一项研究在 3 个模型、8 类任务上评了 4 种编辑方法,事实改对了,推理、问答等通用能力跟着下降。论文 §8.1 是这样权衡的:参数记忆信息密度更高、更省存储,文本记忆可解释、可编辑,在医疗这类需要信任的场景,可解释性更要紧。
对这个电影清单,我倾向保留文本:哪次对话说了什么、改了哪条偏好,都能直接找到。换到别的任务,取舍未必一样。
怎么知道是记忆帮上了忙
如果 Alice 在最后一个问题里重复了“不看恐怖片”,助手答对,也可能只是读到了眼前这句话。要检查以前的记忆有没有用,得把这次重复提示去掉。
论文在评估部分区分了两种评估:直接评估记忆本身,和通过完整任务间接评估。后者更接近实际使用,但更难定位是哪部分出了力。论文 §6.3 的原话是任务表现能归因到多种因素,记忆只是其中之一。直接评估也不便宜:主观评估要雇人判连贯和合理,评分者之间的偏差让结果难复现;客观评估则用预定义问题的正确率。落到这个例子:直接评估只看那条偏好能不能取回来;间接评估从问时间开始把整场对话跑一遍,答对了也分不清是偏好起了作用,还是开头那句提示里就带着答案。
我会沿着这个案例补两道小检查。这是我自己的测试想法,还没跑过:
- 只给新片单,看它能否找回旧偏好;
- 明确说“今天例外”,看它会不会照样机械地套用旧记录。
第二道要是失败,就回去看这次确认有没有写入、旧条目是不是仍被当作当前约束。电影可以重选,记忆怎么更新,得在这一步说清楚。
综述写成时(2024 年 4 月),作者说还没有面向智能体记忆模块的开源基准。半年后 LongMemEval 补上了:500 道题嵌在可伸缩的多轮对话历史里,测五种能力,商业聊天助手和长上下文模型在跨多次交互记信息时掉了约 30% 准确率。它的五项里有知识更新(knowledge updates)和拒答(abstention),正好对着我这两道小检查。真要做,我会先借它的题面,而不是自己从零出题。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。