Thought、Action、Observation 三步一轮,关键是搜索结果真的送回下一轮;附失败分类和后来者怎么改它。
给语言模型接搜索工具,最省事的想法是在提示词里写一句“不知道就先搜索”。可模型写出搜索请求以后,谁去执行?结果怎么交回来?交回来之后是接着搜还是直接回答?这些得靠程序配合,光改提示词做不完。
ReAct 把这段过程写得很直观,一次循环记三样东西:
- Thought:模型对下一步的考虑;
- Action:准备执行的动作;
- Observation:动作执行后的返回。
读论文时可以先不管 Agent 的各种定义,把它当成一个边查资料边答题的程序。下文引的是 arXiv 上的 v3,也就是 ICLR 2023 的定稿版,附录编号以它为准。
Observation 必须来自工具,不能让模型自己编
论文的 Wikipedia 环境只有三个动作(§3.1):search[entity] 返回这个实体维基页的前 5 句;lookup[string] 返回当前页里含这个字符串的下一句,像浏览器的 Ctrl+F;finish[answer] 交出答案。示例按这个格式写,模型接着示例生成下一步,程序取出 Action、调用对应接口,再把返回内容接在 Observation 后面。
下面是便于说明的伪代码,省略了接口解析和错误处理:
history = [tool_instructions, react_examples, question]for step in range(max_steps): thought, action = model.next_step(history) history.append((thought, action)) if action.name == "finish": return action.answer observation = tools[action.name](action.input) history.append(observation)tool_instructions 和 react_examples 分别是工具说明和带完整轨迹的示例,模型先读这些才知道怎么调用。history 逐轮累积,每转一轮,新的 Thought、Action 和 Observation 依次接在后面,下一轮读到的就是这份记录。max_steps 是步数上限,伪代码里走满就停。
论文里的几个具体设置(§3.2)值得对一下:
- 模型是冻结的 PaLM-540B,不做微调;
- 示例是从训练集随机挑的,HotpotQA 6 道、FEVER 3 道,再由人手写成完整的 ReAct 轨迹;
- 步数上限 HotpotQA 7 步、FEVER 5 步;
- 走满还没答案时,论文不是直接停,而是退回 CoT-SC(采样 21 条思维链投票)再答一次。
最后一条我觉得比伪代码更实在:步数耗尽是一种失败信号,应该接一条备用路径,而不是交一个半截答案。
最要紧的一行还是 observation 从工具返回。要是让模型连着 Action 一起往下写,它可以编出一整段“我搜了什么、看到了什么”,程序却一次都没搜。格式再像,也没用上外部资料。
一次歧义,让查询多改写了一轮
论文附录有道题,要找 Colorado orogeny 东部延伸地区的海拔范围。这道题也是论文 Figure 1 的题面。名字陌生,顺着检索走就清楚了:
- 查 Colorado orogeny,当前页只介绍这次造山活动;
- 用
lookup找 eastern sector,得知它延伸到 High Plains; - 搜 High Plains,结果提示这个名字对应不止一个地区;
- 加上 United States 再查,拿到 1,800 至 7,000 英尺的范围。
完整提示轨迹在附录 C.1。第 2 步的 Observation 只有一句话,正是因为 lookup 只返回下一句匹配的句子。
第 4 步的 United States 是为了解决刚看到的歧义才加的,事先写好的固定搜索清单未必处理得了。自己接工具时也要留出继续查的入口,别让第一次搜索结束就无条件进入总结。
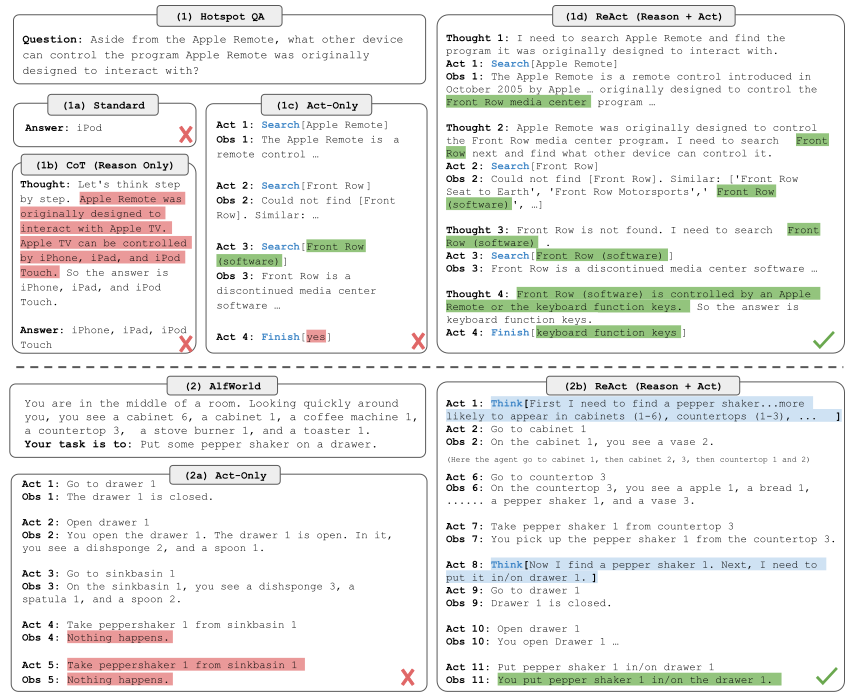
图源:论文 Figure 1,版权归原作者。看图时可以对照每次 Observation,再看模型接着采取了什么动作。
Thought 也不必每步都写很长。论文 §2 说,决策类任务里 thought 只需要“稀疏地出现在最相关的位置”。交互环境里连续执行几个已经明确的动作很正常,碰到障碍再重新考虑。项目页 展示了这种稀疏推理的轨迹,也留了失败示例。这种记录调试起来方便:动作失败后有没有发现,搜索落空后有没有换查法,都看得到。
但完全不要 thought 也不行。§4 里只行动的 Act 版本会拆不出子目标,或者跟丢环境状态,六次对照试验里 ReAct 都更好。
接上搜索,HotpotQA 反而低了
论文用 PaLM-540B,表 1 的结果并不是每个任务都提升。把全表摊开,更能看出作者真正想说什么:
| 方法 | HotpotQA(精确匹配) | FEVER(准确率) |
|---|---|---|
| Standard(直接答) | 28.7 | 57.1 |
| CoT | 29.4 | 56.3 |
| CoT-SC | 33.4 | 60.4 |
| Act(只行动) | 25.7 | 58.9 |
| ReAct | 27.4 | 60.9 |
| CoT-SC → ReAct | 34.2 | 64.6 |
| ReAct → CoT-SC | 35.1 | 62.0 |
| 有监督 SoTA | 67.5 | 89.5 |
两个任务上最好的都是混合行:HotpotQA 是 ReAct 先跑、没答案再退回 CoT-SC,FEVER 是反过来。所以论文并没说“ReAct 最强”,它的态度是模型自己的知识和外部检索要按情况切换。还有一个容易忽略的水位:few-shot 提示离有监督上限差了一大截。
HotpotQA 上单跑 ReAct 比 CoT 低,作者的解释是格式约束:Thought/Action/Observation 的结构让推理步骤没那么自由,换来的是每一步都踩在查到的事实上。ReAct 两个任务都胜过 Act,说明 thought 对行动确实有用。
这些数字也绑在 PaLM-540B 上。附录 A.1 换成 GPT-3(text-davinci-002)后,HotpotQA 从 29.4 到 30.8(这里的 29.4 是附录表 5 里 PaLM-540B 的 ReAct 结果,和表 1 的 27.4 口径不同),ALFWorld 从 70.9% 到 78.4%,作者归因于 GPT-3 做过指令跟随微调。HotpotQA 只评了 500 道验证题,样本不大,小数点后的差别别太当真。
失败案例里,搜不到占两成多
作者在错误分析里提到,搜索质量会影响 ReAct,有时它还会反复采取相同动作。表 2 给了具体比例(HotpotQA):
- 成功案例里也会混进幻觉:CoT 14%,ReAct 6%;
- CoT 的失败案例里,56% 是幻觉;
- ReAct 的失败案例里,47% 是推理错误(包括反复走同一步、出不来),23% 是搜索没拿到有用信息,29% 是标注本身有歧义(CoT 这一项是 28%)。
CoT 主要死在编事实上,ReAct 编得少,却容易在推理上打转。重复动作被作者单独点名为 ReAct 特有的毛病,脚注怀疑和贪心解码有关。查不到相关页面,循环跑再久也补不出需要的知识。
这一轮的外来证据只来自工具返回。返回为空或和问题无关时,它没提供要查的事实;但“这次没查到”会作为失败反馈进入下一轮上下文,模型可能据此改写 query。
后来的 ReWOO 把这个弱点推到了极端:让所有工具都只回 “No evidence found.”,ReAct 准确率掉了 40.8 个点,token 反而多花 851。论文描述的场景很眼熟,工具 A 失败转 B,B 又失败转回 A,一直撞到 token 上限。ReWOO 的办法是先把整份计划写完再统一取证据,HotpotQA 上平均 token 从 ReAct 的约 9800 降到约 2000。
跳出维基:同一个循环接上环境动作
论文的另一半是交互环境(§4)。动作从 search 换成开门、拿东西、点商品按钮,循环不变:
| 环境 | ReAct | 对照 |
|---|---|---|
| ALFWorld(文字版家务,成功率) | 最好一次 71% | Act 45%,BUTLER 37% |
| WebShop(网购,成功率) | 40.0% | 模仿学习 29.1%,IL+RL 28.7%,人类 59.6% |
这两个环境只用了一到两个示例,摘要里的说法是比模仿学习和强化学习方法分别高出 34 和 10 个百分点。离人类还差得远,但对一份提示词来说已经很能打。
后来的人怎么修这个循环
ReAct 失败以后自己救不回来,这是后续工作最常拿来下手的地方。
- Reflexion(同组作者)在外面再套一层:一轮失败后让模型写一段语言反思,下一轮带着它重试。ALFWorld 134 题里完成了 130 题,而纯 ReAct 在第 6、7 次试验之间就不再进步;不过在 WebShop 上,反思没带来明显提升。
- Huang 等人(ICLR 2024)给了反面证据:没有外部反馈、纯靠模型自己反省的“内在自我纠正”,在推理任务上有时纠正完反而更差。我的理解是,Reflexion 能起作用,靠的还是环境给出的成败信号,不是反思本身。
- Toolformer 走另一条路:不靠人手写轨迹示例,让模型自己学会该调哪个 API、怎么把结果接回去。
框架这边,ReAct 这个名字用得越来越少,机制一直沿用。LangGraph 的 create_react_agent 说明就是“循环调用工具,直到满足停止条件”,但它已经废弃,官方让改用 create_agent;LangChain 现在的 agents 文档干脆只说 agent 是“模型在循环里调用工具,直到任务完成”。Anthropic 的 Building effective agents 把 agent 定义成按环境反馈循环使用工具的 LLM,强调每一步都要从环境拿到真实结果。说到底还是那句:Observation 必须来自工具。
调试从最终答案往回查
挑出答案里的一个事实,找是哪次返回提供了它。没有对应材料,就看是 query 写偏了,还是生成时自己补了内容。重复动作也能直接从轨迹里看出来:同一个 query 连续执行却没有新结果,就该检查停止或改写条件。项目页也提到,ReAct 的格式方便人检查,改几句 thought 就能纠正行为。
代码与提示示例 里保留了这些调用格式,接自己的工具时可以逐段对照。仓库是四个 notebook(hotpotqa、fever、alfworld、webshop)加 wikienv.py 和 prompts/ 目录,提示词都在后者里。作者在 README 里也建议,想跑别的任务可以直接去看 LangChain 的 zero-shot ReAct Agent。如果现在接自己的工具,我会先照这四份 notebook 把步数上限和失败回退补齐,再谈换框架。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。