调用成功不够,返回得让后文更好预测:Toolformer 的筛选阈值、数据量和它后来的样子。
一段文本准备介绍 Pittsburgh 的别称,模型可以问工具“它有什么别称”,也可以问“它在哪个国家”。两个问题都能拿到正确事实,但接下来要写的是 Steel City,问国家对这段续写没什么帮助。
Toolformer 的 Figure 2 把这两种候选放在一起。我觉得它最能说明训练数据怎么筛:调用成功不够,返回还得对眼前这段文本有用。否则模型很容易学会到处调工具,文章却没因此写得更好。
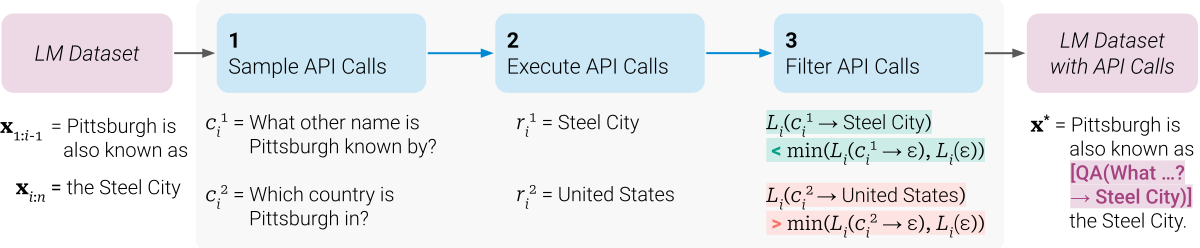
图源:论文 Figure 2,版权归原作者。图中没有给出这两条候选的具体损失值。
留下一条调用,要比两个基准都好
论文先给每种工具少量人工示范,让模型在普通文本的合适位置提出调用候选;真正执行之后,在三种上下文下计算同一段后续文本的预测损失:
- 完全没有调用;
- 写了调用,但没有返回;
- 调用和返回都在。
第 3 种要比前两种里较好的那个还好,并超过阈值,样本才留下。三者比的都是同一段后续文本,区别只在前面有没有调用和返回。
阈值有具体数字。论文 §2 和附录 A.1 写的默认值是损失至少降 1.0(τ_f=1.0);在这之前还有一道位置筛选,模型在某处插入 <API> 的概率要到 5% 以上,每种工具只看概率最高的 5 个位置、每个位置采样 5 条调用。计算器和翻译是例外:τ_f 放到 0.5,位置看 20 个、每处采样 10 条。损失计算还给近处的 token 更大权重(权重 max(0, 1−0.2t)),返回离被它帮助的那几个词越远,越不算数。
为什么连“只有调用”也要比?因为问题本身就可能透露答案方向:问了别称,这几个字已经暗示接下来要说什么。取两档里较好的做基准,问句自带的提示就不算数,只有返回额外带来的那部分才算增益。照这个办法,关于国家的正确事实可能被丢掉,能帮着续写别称的结果留下。
计算器那条也一样。论文 Figure 1 里,原文从 1400 名参与者、400 人通过,写到通过比例,中间插入除法调用,返回舍入后的 0.29,再接着写 29%。工具给的正是下一段需要的计算结果,文本仍按原句往下生成。训练好的模型在调用结束处暂停,由外部执行器计算、接回结果,再继续输出。
模型学会的是何时调用,能力仍在外部
筛好的增强文本用来继续训练 GPT-J 6.7B,目标仍是预测后续 token。模型学到的是什么时候插入调用、参数怎么写、返回怎么用。它没有凭空长出计算器或搜索能力:每种 API 要有人实现,候选也必须真正执行。论文 §3 里的五件工具都很朴素:计算器只做四则运算、保留两位小数(0.29 就是这么来的);Wikipedia 搜索是 BM25 检索 KILT 的维基快照;问答背后是另一个检索增强模型 Atlas;翻译用 NLLB-600M;日历不收参数,只返回当天日期。
阈值一调,数据量差几十倍
造训练集的实际工作量也在这里。Wikipedia 搜索和计算器留下的数据量不同,阈值调高以后,能留下的候选还会明显变少。论文 Table 2 给了每种工具在三档阈值下留下的样本数:
| 工具 | τ_f=0.5 | τ_f=1.0 | τ_f=2.0 |
|---|---|---|---|
| 问答 | 51,987 | 18,526 | 5,135 |
| Wikipedia 搜索 | 207,241 | 60,974 | 13,944 |
| 计算器 | 3,680 | 994 | 138 |
| 日历 | 61,811 | 20,587 | 3,007 |
| 翻译 | 3,156 | 1,034 | 229 |
默认阈值下搜索留六万多条,计算器不到一千条,差了两个数量级。论文 §7 自己也承认采样很低效:处理一百多万篇文档,只换来几千条有用的计算器调用。普通网页文本里需要算术的地方本来就少,这是给计算器单独放宽阈值的原因。
训练本身反而不重。附录 B 写的是每种 API 最多 25k 条样本、最多 2k 步、8 张 A100 40GB。贵的是前面那一百万篇文档的采样、执行和打分。
SVAMP:差距几乎全在接回返回这一步
| 设置 | SVAMP |
|---|---|
| 原始 GPT-J | 5.2 |
| Toolformer,禁用工具 | 6.3 |
| Toolformer,启用工具 | 29.4 |
| GPT-3 175B(对照) | 10.0 |
这组比较 特意把“接到返回”分了出来:光训练过带调用的文本,拿不到同样的收益。“禁用工具”指同一个 Toolformer 解码时关掉调用,并没有另训一个模型。禁用工具的 6.3 离原始的 5.2 不远,从 6.3 到 29.4 的差距基本出在返回这一环,算术仍由外部执行器完成。同一张表里 GPT-3 175B 只有 10.0,6.7B 加一个四则计算器就是它的近三倍。
调用率本身也是个旋钮
这些分数里有一部分来自解码设置。论文为了让模型更愿意调工具,只要 <API> 排进前 k=10 个候选 token 就插入调用。§5 的 Table 9 对比了 k=1(普通贪心)和 k=10:T-REx 上调用率从 40.3% 升到 98.1%,总分从 47.8 到 53.5,但没调用的那部分题从 44.3 掉到 22.5。调用率是被推上去的,剩下不调用的多半是模型确实拿不准的难题。
反过来,工具给了也不一定学得会。论文统计,数学题 97.9% 用了计算器,但 TempLAMA 上日历只用了 0.2%。哪种工具在什么时候被用,基本由留下来的训练数据决定。
为什么串不起来
主评测每个输入最多调用一次 API,论文给的理由是防止模型陷进反复调用的循环。先查人名、再查这个人的资料这种依赖链,从这组结果推不出来。§7 说得更直接:各工具的调用是分别生成的,微调数据里根本没有串联调用的样例,模型也不能翻检索结果、改写查询。另外 §4.4 发现,用工具的能力在约 775M 参数附近才出现,更小的模型给了工具也用不起来。
正确的返回也可能被丢掉
原论文的数据构造部分列了过滤和采样设置。阈值是最后一道关,一条候选留不留,先看它让哪段后续文本更好预测。事实正确的返回也可能被丢掉,只要它让这段后续文本的预测损失降得不够阈值。
这个代理指标论文自己也只说“通常”成立。§5 Data Quality 承认损失降得多一般是有用调用,但也举了反例:一条搜 “Fast train success” 的 Wikipedia 调用没提供任何相关信息,困惑度照样降了。作者的态度是留下一点噪声反而好,可以逼模型不盲信每次返回。我觉得这个说法成立一半:它说明筛选器从头到尾衡量的是“后文好不好预测”,事实对错从来不在它的视野里。
今天“该不该调”变成了显式配置
Toolformer 想让模型自己学会“这里该调吗”。今天的接口把这件事拆开了:模型只输出结构化调用,执行交给你的程序。Claude 的 tool use 文档默认 tool_choice=auto,描述模型的判断方式:
It calls a tool when the request maps to that tool’s described capability and the answer isn’t already in context.
“答案已经在上下文里就别调”,几乎就是 Toolformer 筛选标准的产品版。OpenAI 的 function calling 则用 strict 让参数严格符合 schema,并默认允许一轮里并行调多个函数,parallel_tool_calls=false 才限制到零或一次。论文那条“每个输入最多一次调用”是当年的工程取舍,现在默认反过来了。
“不该调时别调”也成了单独的评测项。Berkeley Function Calling Leaderboard 专门设计了给出的函数都不相关、正确输出是不调用的题。τ-bench 测多轮对话里的工具使用,gpt-4o 这一类模型成功率不到一半。
后续工作也补上了论文自陈的短板:ToRA 把工具调用编进推理过程,Search-R1 用强化学习让模型在推理中自己发起多次搜索,ToolLLM 把工具从 5 个扩到 RapidAPI 上的 16,464 个。学时机这件事交给了强化学习,工具规模也扩到上万,但“返回要对眼前这段有用”这个标准一直没变。
留下几句话 读者来信
读到这里,有什么想法?欢迎留下你的看法。